
关于作者
Haggai Roitman 在 AI 研究与大规模生产系统的交叉点上耕耘了二十余年。他的工作贯通理论与实践——从发表基础性研究,到交付服务数百万用户的系统。
他的研究兴趣涵盖信息检索、推荐系统、自然语言处理、大语言模型、面向 LLM 的强化学习以及智能体 AI。他已发表逾 100 篇同行评审论文,并拥有约 100 项专利。他在 Technion——以色列理工学院取得本科(Cum Laude)与博士学位。
当他不思考梯度流与键值缓存(KV Cache)时,可以在打碟机前找到他——在那里他混音 progressive trance 与 deep house。
前言
为什么要写这本指南
在 2026 年构建智能 AI 系统,需要掌握极其广阔的知识——从 Transformer 在内部如何处理语言,到使训练成为可能的硬件与系统,再到让训练高效的优化技术、教会模型推理并与人类意图对齐的强化学习算法,乃至大规模协调自主系统的多智能体架构。
这些知识散落在数百篇论文、博客文章、GitHub 仓库,以及少数实验室内部的「部落知识」之中。本指南之所以存在,是因为从业者需要一份覆盖整套技术栈的统一参考——不仅是理论,更是让事情真正跑起来的实现细节。
我个人走向智能体 AI 的旅程
我对智能体(Agent)的迷恋始于二十年前,那时我还在攻读信息系统工程的本科学位。我选修了面向智能体的软件工程(Agent-Oriented Software Engineering, AOSE)[381] 课程,并学习如何用 JADE[22](Java Agent DEvelopment Framework)构建多智能体系统——这是一个遵循 FIPA[93] 标准的平台,智能体之间通过结构化协议通信、就共享资源协商,并自主协作。与此同时,Berners-Lee、Hendler 与 Lassila 发表的奠基性论文《The Semantic Web》[24] 描绘了一种机器可读知识的愿景,让智能体能够在其上推理。这两条线索——自主智能体架构与语义知识表示——种下了一颗种子,此后一直引导着我的职业生涯。一个早期项目让这一愿景具体化:在我未来尊敬的学术导师 Prof. Avigdor Gal 的指导下,我们尝试用 OntoBuilder[103] 构建一个购物智能体——一个能够在不同异构网站上自动填写商品搜索查询与订单的系统,通过本体匹配与映射来理解它们各异的 schema。Semantic Web 承诺,在一个结构化、机器可读的世界里,这类智能体将大放异彩。然而在实践中,手工本体的脆弱性、真实商品数据的混乱,以及缺乏稳健的自然语言理解,让这个愿景永远停留在「还有五年」。
在随后的岁月里,我亲历了 AI 进步的每一次浪潮:用于组合优化的神经网络与启发式搜索;深度学习与表征学习;大规模信息检索与个性化;以及最近的大语言模型革命。每一波浪潮都带来强大的新工具,但梦想始终未变:构建能在复杂环境中自主理解、推理与行动的系统。
2024–2026 年之所以非凡,是因为这些线索终于汇合在一起。LLM 提供语言理解与生成能力;强化学习教会它们推理并与人类意图对齐;工具使用协议(Model Context Protocol, MCP)赋予它们在世界中行动的「手」;智能体编排框架提供了二十年前 JADE 曾设想过的协作层——只是现在由基础模型驱动,而非手工编写的本体。在很多意义上,本指南正是我希望自己在那段旅程的每一步都能拥有的参考。
2026 年的全景
通向今天智能体 AI 系统的旅程,横跨三十年间在架构、训练与部署上不断累积的突破:
- 架构基础(2017–2020):Transformer[357] 把 self-attention 引入为一种通用的序列处理原语。Scaling Laws 揭示:用更多数据训练的更大模型会稳定地变好。GPT-2 与 GPT-3 证明,仅 decoder 结构的 Transformer 在足够规模化之后,会成为有能力的 few-shot learner。
- 系统与效率(2020–2023):Flash Attention[64] 通过消除显存瓶颈让训练加速 2–4。LoRA[147] 让在单个节点上微调 70B+ 模型成为可能。专家混合(Mixture-of-Experts, MoE)将模型容量与算力成本解耦。vLLM 这类推理引擎把吞吐量带到了实时应用可触及的范围。
- 通过 RL 实现对齐(2022–2024):RLHF[280] 把有能力但不受用的基础模型转变为有用的助手——这正是 ChatGPT 背后的配方。直接偏好优化(DPO)[302] 把奖励模型与 RL 循环压缩为单一的监督损失,让对齐走向普及。变体大量涌现:KTO[86]、IPO[14]、ORPO[141]、组相对策略优化(GRPO)[323]。
- 推理与自主性(2024–2026):DeepSeek-R1[69] 与 OpenAI 的 o1/o3 证明,RL 能够教会推理本身——模型会自发地发现思维链、回溯与自我验证。与此同时,模型上下文协议(Model Context Protocol, MCP)把工具访问标准化,智能体到智能体通信(Agent-to-Agent, A2A)实现了智能体之间的通信,生产级编排框架也走向成熟。
本指南适合谁阅读
本文档写给动手构建系统的从业者:
- ML 工程师——需要理解 Transformer 内部机制、训练基础设施、优化方法,以及训练为什么会发散。
- 应用研究者——为自身特定领域评估架构、微调策略与 RL 方法。
- 智能体开发者——构建生产系统,需要编排模式、记忆架构、工具集成(MCP)与多智能体协作(A2A)。
- 系统工程师——负责训练基础设施、GPU 集群、分布式训练与推理部署。
- 技术负责人——在全栈范围内做出架构与资源投入决策。
我们假定你熟悉神经网络与基础概率。不要求事先掌握 LLM、RL 或系统知识——本指南从第一性原理出发逐步构建。
你将获得什么
读完本指南后,你将能够:
- 理解 LLM 内部机制——attention 机制、位置编码、MoE 路由、Flash Attention,以及为什么架构选择会影响下游能力。
- 从系统层面推理——GPU 显存预算、分布式训练策略(完全分片数据并行(FSDP)、张量并行/流水线并行)、推理优化,以及用 vLLM 进行生产部署。
- 高效地训练与微调——LoRA/QLoRA、量化、知识蒸馏、优化器选择与学习率调度。
- 让模型与人类偏好对齐——实现 RLHF/直接偏好优化(DPO)/组相对策略优化(GRPO)/KTO 流水线,调试奖励作弊与模式崩溃,在 20 多种方法中选出合适的算法。
- 构建推理模型——理解 DeepSeek-R1、o1/o3 与 QwQ 如何在没有任何显式示范的情况下通过 RL 发现思维链。
- 设计智能体系统架构——选择编排模式、设计记忆、通过 MCP 集成 tool、通过 A2A 协调智能体,并用生产级基准进行评估。
- 严谨地评估——为模型质量与智能体能力应用合适的指标、基准与 LLM-as-Judge 模式。
本指南的组织结构
本指南共 30 章,分为六个部分:
- 第 I 部分——基础(第 1–3 章):LLM 架构与优化(transformer、attention、位置编码、Flash Attention、LoRA、MoE),系统基础(GPU 层级结构、分布式训练、vLLM),以及经典 RL 理论(MDP、策略梯度、actor-critic)。
- 第 II 部分——面向 LLM 的 RL 方法(第 4–12 章):完整的 RL-for-LLMs 工具集。先讲语言模型的 RL 基础,随后是对 PPO、DPO、GRPO 以及偏好优化变体(Online DPO、KTO、IPO、ORPO、SimPO)的完整数学处理,还包括奖励模型训练、监督微调(SFT)最佳实践、大规模系统架构,以及轨迹级 RL 的智能体训练。
- 第 III 部分——推理(第 13 章):大型推理模型——DeepSeek-R1、OpenAI o1/o3/o4-mini、QwQ——RL 如何发现思维链、蒙特卡洛树搜索(MCTS)、过程奖励模型,以及测试时计算扩展。
- 第 IV 部分——评估(第 14 章):全面的 LLM 评估方法论——指标、LLM-as-Judge、人工标注、基准套件、数据污染检测与智能体评估。
- 第 V 部分——智能体 AI(第 15–27 章):完整的智能体技术栈——智能体 AI 导论、检索增强生成(RAG)与检索、记忆系统、编排与上下文管理、循环工程、设计模式、智能体环境与基准、模型上下文协议(MCP)、智能体技能、智能体到智能体通信(A2A)、多智能体系统、开发框架与智能体 UI。
- 第 VI 部分——测评与参考(第 28–30 章):108 道详细的测验题及覆盖全部主题的完整解答;一章快速参考,汇总关键公式、API 参考与失效模式诊断;以及一章包含未来方向的结语。
本指南包含 100 多道详细的测验题及覆盖全部主题的完整解答,另有一章快速参考,汇总关键公式、API 参考与失效模式诊断。
设计理念
本文档由三条原则指导:
- 先直觉,后形式化。每个公式之前都会先用平实的语言说明它的含义以及为什么重要。
- 面向实现。如果不知道如何让它真正跑起来,理论就没有用。全书贯穿代码、超参数表、显存预算、架构图与调试策略。
- 对什么真正有效保持诚实。我们会明确指出哪些方法是经过生产验证的,哪些还处于研究探索阶段。
范围与有意省略
本指南聚焦于文本输入、文本输出的语言模型,以及围绕它们构建的 RL、系统与智能体基础设施。有几个重要领域被有意排除在外:
- 多模态模型(视觉–语言、音频、视频)。多模态架构引入了独特的训练流水线(对比式预训练、跨模态对齐、模态专用编码器)、数据治理挑战与评估协议,每一项都值得用一本书的篇幅来讨论。把它们纳入进来会让篇幅翻倍,却无法加深统一本指南的 RL 与智能体内核。
- 特定领域部署(医疗、法律、金融、科学发现)。领域适配引入了与本指南所述通用方法正交的监管约束、专门评估与数据获取问题。我们介绍的算法与架构正是从业者适配到这些领域的基本构件,但适配细节更适合由专门的参考资料来讲解。
- 个性化与推荐系统。个性化依赖于用户建模、协同过滤与交互历史架构,构成了一条平行的研究传统。尽管 LLM 正越来越多地被用于推荐系统之中,但其核心技术(序列模型、基于 bandit 的探索、冷启动处理)差异足够大,值得单独讨论。
通过守住这条边界,我们保持了一条连贯的主线——从架构基础与系统基础设施,经过产生对齐模型与推理模型的训练算法,直到自主智能体的编排与部署——而不会让叙事在多种模态与垂直领域之间碎片化。
—— Haggai Roitman,2026
1.3 版的新内容
1.3 版新增了十九个主题,反映了截至 2026 年中期的发展:
- 第 1 章——LLM 架构与优化: •Muon 优化器——以 Newton–Schulz 正交化作为 AdamW 的继任者(已被 GLM-5、Kimi K2、DeepSeek-V4 采用)。•多头潜在注意力(Multi-head Latent Attention, MLA)——DeepSeek 通过低秩潜在投影实现的 KV cache 压缩。•FP8/FP4 训练——下一代混合精度,配合逐 tile 微缩放。•无辅助损失的 MoE——以自适应偏置为基础的负载均衡,取代代价高昂的辅助损失。•中期训练——介于预训练与 SFT 之间、为模型进入 RL 做准备的新兴阶段。
- 第 2 章——系统基础: •Dynamo——NVIDIA 的数据中心级推理编排框架。
- 第 11 章——大规模系统架构: •Decoupled DiLoCo——Google 的地理分布式训练,带宽降低 236。•Miles——PyTorch 原生的 RL 后训练引擎。
- 第 12 章——LLM 智能体训练: •交互式 RL 环境——用于智能体后训练的 NeMo Gym、RLFactory 与 MOSAIC。•在真实智能体轨迹上训练——把生产轨迹用作 RL 训练信号。
- 第 13 章——面向大型推理模型的 RL: •推理时计算扩展定律——对数线性关系与预算感知提示。•潜空间推理——coconut 式的连续思考,不依赖 token 级思维链。•同策略自蒸馏——从模型自身拥有的特权上下文获得密集的 token 级监督,以低 10–100 的计算达到 RL 级别的推理能力。
- 第 17 章——智能体记忆系统: •主动记忆架构——Meta AI 的行为状态衰减与预期性检索。
- 第 19 章——循环工程: •上下文工程——优化上下文窗口中填什么内容的学问(Lütke、Karpathy、Anthropic)。
- 第 21 章——智能体环境: •UniClawBench 与 Terminal-Bench——面向机器人操作与长时程终端任务的 2026 年基准。
- 第 25 章——多智能体系统: •BDI-LLM 自演化智能体——带有可学习计划库的信念–愿望–意图架构。
- 第 26 章——智能体开发框架: •NVIDIA OO Agents(NOOA)——面向对象的框架,其中智能体是 Python 对象,方法是 tool,而
...主体则变成由 LLM 驱动的循环。
引言
宏观图景
本指南带你从 第一原理走到生产系统。它面向那些希望理解并构建现代 AI 完整技术栈的从业者——研究者、工程师与应用科学家:从 Transformer 架构与运行它们的硬件,到使模型与人类意图对齐并教会它们推理的训练算法,再到把模型作为自主系统部署出去的智能体架构。
核心论点很简单:构建优秀的 AI 系统需要理解整条流水线,而不仅是某一层。调试训练过程的工程师需要理解 GPU 显存层级与优化器动力学。做微调的从业者要知道何时 LoRA 已足够、何时全参数训练值得这个成本。Agent 开发者需要理解底层模型是如何训练出来的。评估框架的技术负责人需要理解每个框架做出了怎样的权衡。本指南提供这幅完整的图景。
通往智能体 AI 之路:一段简史
今天的智能体 AI 系统并非凭空出现。它们站立在数十年间一系列里程碑式系统之上——每一个都解决了一个更窄的问题,但它们共同积累起的技术、硬件与雄心,最终让自主智能体成为可能。
- Deep Blue(1997)[37]——IBM 的象棋引擎以暴力搜索(每秒 2 亿个局面)配合手工评估函数,击败了世界冠军 Garry Kasparov。它证明了机器在边界清晰的对抗性领域可以超越人类,但无法泛化到其他任何任务。
- IBM Watson——Jeopardy!(2011)[90]——Watson 结合了信息检索、NLP 与大规模并行,在开放领域问答中战胜人类冠军。它表明 AI 能够在规模上处理非结构化文本,但需要多年针对领域的工程,且如果没有大量人力,便无法学习新领域。
- AlexNet 与深度学习革命(2012)[192]——Krizhevsky 等人的 CNN 在 ImageNet 上以惊人的领先优势夺冠,证明了在 GPU 上训练的深度神经网络可以从原始数据中学到表征。仅此一个结果便引爆了现代深度学习时代,以及最终让 LLM 成为可能的硬件投入。
- AlphaGo(2016)[331]——DeepMind 的系统用深度 RL(policy 网络 + value 网络 + 蒙特卡洛树搜索)击败了围棋世界冠军 Lee Sedol。与 Deep Blue 的暴力搜索不同,AlphaGo 是学会下棋的——证明了 RL 能够攻克仅靠搜索无法处理的领域( 个棋盘状态)。随后 AlphaGo Zero(2017) [332] 完全通过自我对弈学习,根本不需要任何人类棋谱。
- GPT-2/GPT-3(2019–2020)[32]——OpenAI 表明,把 decoder-only Transformer 扩展到数十亿参数会涌现出 few-shot learning 能力。GPT-3(175B 参数)仅凭上下文示例,就能完成它从未被显式训练过的任务——翻译、算术、代码生成。基础模型的时代由此开始。
- AlphaFold(2020)[174]——DeepMind 解决了悬而未决 50 年的蛋白质折叠问题,以原子级精度预测蛋白质 3D 结构。AlphaFold 证明了深度学习能够攻克此前被认为距离我们还有数十年的根本性科学难题,同时也展示了「架构创新(在残基对上做 attention)+ 大规模算力」组合的威力。
- ChatGPT 与 RLHF(2022)[280]——InstructGPT/ChatGPT 证明:一个有能力的 base 模型,在经过 RLHF 对齐后,会变成真正有用的助手。这是一个拐点:AI 从研究工具变成了被亿万用户使用的消费产品。其对齐技术(reward 模型、PPO)成为此后所有 LLM 后训练的模板。
- GPT-4 与多模态模型(2023)[274]——多模态能力(视觉 + 语言)、更长的上下文以及更强的推理把 LLM 推向通用认知。工具使用(代码解释器、网页浏览)已透露出智能体能力的迹象。
- 推理模型(2024)[69]——OpenAI 的 o1 与 DeepSeek-R1 表明,RL 可以教会模型推理:思维链、回溯、自我验证仅从奖励信号中自发涌现。模型开始能够求解竞赛级数学题和复杂编码任务。
- 智能体 AI(2025 年至今)——汇聚点:具备推理能力的 LLM,配备了标准化的工具访问(MCP)、智能体间通信(A2A)、持久记忆以及精密的编排框架。Agent 现在能够自主编写代码、开展研究、管理工作流,并与其他 Agent 协同——这正是本指南的主题。
本指南从基础模型时代接起这段故事,并沿着对齐、推理与自主智能体能力一路向前推进。
本书内容概览
第 I 部分:基础(第 1–3 章)构建本指南其余部分所依赖的基础知识。我们首先讨论 LLM 的内部工作原理——决定能力的架构选择——然后介绍让训练与推理成为可能的硬件与系统,最后从第一原理出发引入强化学习。
- 第 1 章——LLM 架构与优化:Transformer 内部机制(自注意力、多头注意力、RoPE、GQA)、Flash Attention、优化方法(AdamW、学习率调度、梯度裁剪)、混合精度、LoRA/QLoRA、量化、知识蒸馏,以及专家混合(MoE)。
- 第 2 章——系统基础:GPU 架构(A100/H100/B200)、显存层级、NVLink/NVSwitch、分布式训练(FSDP、DeepSpeed ZeRO、张量并行/流水线并行(Pipeline Parallelism)),以及用于高吞吐推理的 vLLM。
- 第 3 章——RL 导论:MDP、贝尔曼方程(Bellman Equations)、TD 学习、Q-learning、策略梯度(REINFORCE)、actor-critic 方法、广义优势估计(GAE)——支撑第 II 部分的算法工具箱。
第 II 部分:面向 LLM 的 RL 方法(第 4–12 章)是训练与对齐的核心。在这里你将学习如何对齐、改进并微调语言模型——从完整的数学推导到可运行的代码。
- 第 4–8 章:每个主要的 RL/偏好算法,都配有数学推导、直觉解释与 TRL 代码——PPO、DPO、GRPO,以及偏好优化的各种变体(Online DPO、KTO、IPO、ORPO、SimPO、Best-of-N)。
- 第 9–10 章:奖励模型训练(Bradley–Terry、缩放定律、奖励作弊)与监督微调(SFT)最佳实践(数据质量、课程学习、格式设计)。
- 第 11–12 章:规模化系统架构(解耦训练、容错、GPU 分配)与 LLM 智能体训练——如何用轨迹级 RL 端到端地训练智能体。
第 III 部分:推理(第 13 章)涵盖模型能力的前沿——教 LLM 通过多步问题展开推理。
- 第 13 章——面向大型推理模型的 RL:DeepSeek-R1、OpenAI o1/o3/o4-mini、QwQ——RL 如何发现思维链、蒙特卡洛树搜索(MCTS)、过程奖励模型与测试时计算扩展。
第 IV 部分:评估(第 14 章)提供衡量这一切是否真正有效的方法论。
- 第 14 章——LLM 评估:指标(困惑度、pass@k、ELO)、LLM-as-Judge 模式、数据污染检测、基准套件以及智能体评估方法论。
第 V 部分:智能体 AI(第 15–27 章)带你从一个训练好的模型走到部署后的自主系统。这是篇幅最大的一部分,涵盖 Agent 在真实世界中运行所需的一切。
- 第 15 章——智能体 AI 导论:什么使一个系统具备智能体特性、从聊天机器人到自主 Agent 的谱系,以及第 V 部分其余内容所依据的基础概念。
- 第 16 章——检索增强生成(RAG):检索方法、分块、嵌入模型、混合搜索、重排序以及生产架构。
- 第 17 章——记忆系统:工作记忆、情景记忆、语义记忆与程序性记忆,用于为 Agent 提供持久知识。
- 第 18 章——编排:ReAct、Plan-and-Execute、LLM Compiler、反思模式、上下文管理与脚手架(harness)设计。
- 第 19 章——循环工程:推理时强化学习、上下文工程、自适应编排循环,以及 loop-as-policy 抽象。
- 第 20 章——设计模式:Prompt 链式调用、路由、并行化、评估驱动的编排,以及简洁性原则。
- 第 21 章——环境与基准:WebArena、SWE-bench、OSWorld、GAIA——面向智能体能力的评估环境。
- 第 22 章——模型上下文协议(MCP):架构、传输层、tool/resource/prompt 原语、安全性以及部署。
- 第 23 章——Agent 技能:技能库、工具组合与能力抽象。
- 第 24 章——A2A 通信:Google 的智能体到智能体通信(Agent-to-Agent)协议——Agent Card、任务生命周期、流式传输、企业级模式。
- 第 25 章——多智能体系统:层级式、辩论式、市场式与群体式架构——规模化的协调。
- 第 26 章——开发框架:LangGraph、CrewAI、AutoGen、OpenAI Agents SDK、NVIDIA OO Agents——结合代码的对比分析。
- 第 27 章——智能体 UI:流式传输界面、生成式 UI、画布范式、工具可视化、人在回路模式。
第 VI 部分:测评与参考(第 28–30 章)汇集测评材料,并为从业者提供可快速查阅的参考资料。
- 第 28 章——测验题与详解:108 道题涵盖所有主题——架构、RL、推理、智能体系统——并配有详尽的解答。
- 第 29 章——快速参考:关键公式、API 参考、超参数表以及故障模式诊断,采用紧凑的查阅格式。
- 第 30 章——结论与未来方向:这个领域正走向何方——开放问题、新兴范式以及前方的道路。
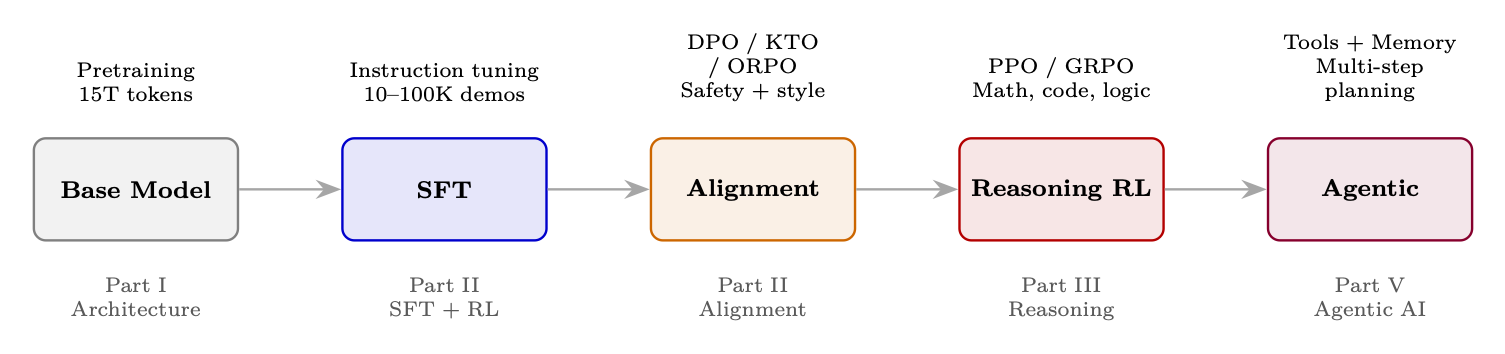
现代 AI 流水线
从 base 模型到已部署 Agent 的完整流水线:
缩略语表
本指南使用了许多源自机器学习、系统工程与智能体研究的缩略语。以下速查表覆盖最常见的那些;每个条目都会出现在概念首次完整引入的章节中。
- A2A
- Agent-to-Agent(智能体到智能体通信协议)
- AdamW
- Adam with decoupled Weight decay(权重衰减解耦的 Adam)
- BDI
- Belief–Desire–Intention(信念—愿望—意图结构)
- BERT
- Bidirectional Encoder Representations from Transformers(Transformer 双向编码器表征)
- BLEU
- Bilingual Evaluation Understudy(双语评估替补,指标)
- BPE
- Byte-Pair Encoding(字节对编码)
- BT
- Bradley–Terry(偏好模型)
- CoT
- Chain of Thought(思维链)
- CTDE
- Centralized Training, Decentralized Execution(集中训练、分散执行)
- CUDA
- Compute Unified Device Architecture(统一计算设备架构)
- DAG
- Directed Acyclic Graph(有向无环图)
- DAPO
- Dynamic Adaptive Policy Optimization(动态自适应策略优化)
- DDP
- Distributed Data Parallel(分布式数据并行)
- DiLoCo
- Distributed Low-Communication(低通信分布式训练)
- DP
- Data Parallelism(数据并行)
- DPO
- Direct Preference Optimization(直接偏好优化)
- DQN
- Deep Q-Network(深度 Q 网络)
- DRAM
- Dynamic Random-Access Memory(动态随机存取存储器)
- ELO
- Elo rating system(以 Arpad Elo 命名的评分系统)
- EOS
- End of Sequence(序列结束,token)
- FA
- Flash Attention(注意力优化算法)
- FFN
- Feed-Forward Network(前馈网络)
- FLOP
- Floating-Point Operation(浮点操作)
- FSDP
- Fully Sharded Data Parallel(全分片数据并行)
- GAE
- Generalized Advantage Estimation(广义优势估计)
- GAIA
- General AI Assistants(通用 AI 助手,基准)
- GEMM
- General Matrix Multiplication(通用矩阵乘法)
- GQA
- Grouped Query Attention(分组查询注意力)
- GRPO
- Group Relative Policy Optimization(组相对策略优化)
- HBM
- High Bandwidth Memory(高带宽内存)
- IPO
- Identity Preference Optimization(恒等偏好优化)
- KL
- Kullback–Leibler(散度)
- KTO
- Kahneman–Tversky Optimization(Kahneman–Tversky 优化)
- KV
- Key–Value(键值,缓存)
- LATS
- Language Agent Tree Search(语言 Agent 树搜索)
- LLM
- Large Language Model(大语言模型)
- LoRA
- Low-Rank Adaptation(低秩适配)
- LR
- Learning Rate(学习率)
- MCP
- Model Context Protocol(模型上下文协议)
- MCTS
- Monte Carlo Tree Search(蒙特卡洛树搜索)
- MDP
- Markov Decision Process(马尔可夫决策过程)
- MFU
- Model FLOPS Utilization(模型算力利用率)
- MHA
- Multi-Head Attention(多头注意力)
- MLA
- Multi-head Latent Attention(多头潜在注意力)
- MLP
- Multi-Layer Perceptron(多层感知器)
- MoE
- Mixture of Experts(专家混合)
- NOOA
- NVIDIA Object-Oriented Agents(NVIDIA 面向对象智能体)
- NLL
- Negative Log-Likelihood(负对数似然)
- OPSD
- On-Policy Self-Distillation(同策略自蒸馏)
- ORPO
- Odds Ratio Preference Optimization(优势比偏好优化)
- ORM
- Outcome Reward Model(结果奖励模型)
- PEFT
- Parameter-Efficient Fine-Tuning(参数高效微调)
- PP
- Pipeline Parallelism(流水线并行)
- PPO
- Proximal Policy Optimization(近端策略优化)
- PRM
- Process Reward Model(过程奖励模型)
- QLoRA
- Quantized Low-Rank Adaptation(量化低秩适配)
- RAG
- Retrieval-Augmented Generation(检索增强生成)
- ReAct
- Reasoning + Acting(推理 + 行动,Agent 模式)
- RL
- Reinforcement Learning(强化学习)
- RLHF
- Reinforcement Learning from Human Feedback(基于人类反馈的强化学习)
- RLVR
- Reinforcement Learning with Verifiable Rewards(基于可验证奖励的强化学习)
- RM
- Reward Model(奖励模型)
- RoPE
- Rotary Position Embedding(旋转位置编码)
- ROUGE
- Recall-Oriented Understudy for Gisting Evaluation(面向摘要评估的召回导向替身,指标)
- RRF
- Reciprocal Rank Fusion(倒数排名融合)
- SDK
- Software Development Kit(软件开发工具包)
- SFT
- Supervised Fine-Tuning(监督微调)
- SGD
- Stochastic Gradient Descent(随机梯度下降法)
- SM
- Streaming Multiprocessor(流式多处理器)
- SPLADE
- SParse Lexical AnD Expansion(稀疏词法扩展)
- SRAM
- Static Random-Access Memory(静态随机存取存储器)
- SSE
- Server-Sent Events(服务器推送事件)
- SWE-bench
- Software Engineering Benchmark(软件工程基准)
- TD
- Temporal Difference(时序差分,学习)
- TP
- Tensor Parallelism(张量并行)
- TRL
- Transformer Reinforcement Learning(库)
- UCB
- Upper Confidence Bound(上置信界)
- vLLM
- vLLM(大语言模型推理与服务引擎)