本章涵盖一类方法,它们以不同的目标函数、数据假设或架构权衡来扩展或替换 DPO。每种方法都针对标准 offline DPO 的某个具体局限:分布偏移(Online DPO)、需要配对数据(KTO)、对噪声标签过拟合(IPO)、参考模型显存开销(ORPO)或训练复杂度(Best-of-N)。
Online DPO
动机
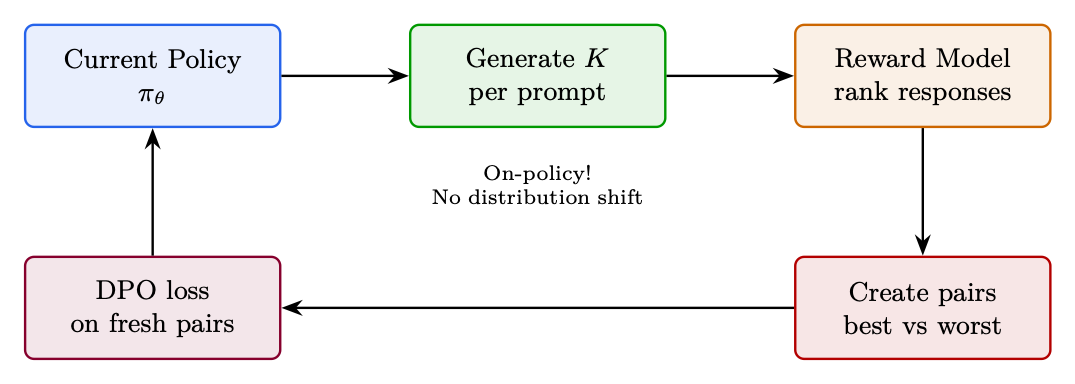
标准 DPO 的主要局限:偏好数据由一个不同的模型生成(通常是较旧的 checkpoint,甚至是不同的模型族)。随着训练推进,policy 生成的文本与训练 pair 已完全不同 loss 在一个无关分布上进行优化。
Online DPO 的解决方案[127]:每一步都从当前 policy 生成新鲜的偏好 pair,用 reward model 判定,然后应用 DPO loss。
算法
- 从当前 为每个 prompt 生成 条响应
- 用 reward model 给所有响应打分
- 构造 pair:最高分 = chosen,最低分 = rejected
- 在这些新鲜 pair 上应用 DPO loss
- 重复(每步重新生成)
TRL 实现
下面给出一个基于 HuggingFace TRL 的最小可运行示例。
from trl import OnlineDPOConfig, OnlineDPOTrainer
from transformers import AutoModelForCausalLM, AutoModelForSequenceClassification

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.1-8B-Instruct",
    torch_dtype=torch.bfloat16)
reward_model = AutoModelForSequenceClassification.from_pretrained(
    "RLHFlow/ArmoRM-Llama3-8B-v0.1", torch_dtype=torch.bfloat16)

online_dpo_config = OnlineDPOConfig(
    output_dir="./online_dpo_output",
    learning_rate=5e-7,
    beta=0.1,                    # DPO beta (same meaning as standard DPO)
    num_generations=4,           # K responses per prompt
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    max_new_tokens=512,
    temperature=0.7,
    bf16=True,
    num_train_epochs=1,
    logging_steps=10,
)

trainer = OnlineDPOTrainer(
    model=model,
    reward_model=reward_model,
    args=online_dpo_config,
    train_dataset=prompt_dataset,
    tokenizer=tokenizer,
)
trainer.train()
Online DPO vs Offline DPO vs PPO
数据模型Loss最适合Offline DPO静态 pair2(policy + reference)DPO快速对齐、算力有限Online DPO从 新鲜采样3(policy + reference + reward model)DPO当 DPO 停滞、需要探索时PPO从 新鲜采样4(policy + reference + reward model + value head)PPO clip极致质量、复杂推理
KTO ——Kahneman-Tversky Optimization
动机
DPO 需要成对的偏好数据:对同一 prompt,你既需要好的响应也需要坏的响应。实际上大多数反馈是未配对的:用户对单个响应给出点赞/点踩,没有匹配的 pair。
KTO 的洞见[86]:使用前景理论(来自行为经济学)。人类对损失的感受比对收益更强烈。“点踩”应当产生比“点赞”更强的 gradient。
Loss 函数
其中 , 是期望 KL 散度(一个滑动 baseline)。
TRL 实现
下面给出一个基于 HuggingFace TRL 的最小可运行示例。
from trl import KTOConfig, KTOTrainer

# Dataset format: {"prompt": str, "completion": str, "label": bool}
# label=True for desirable, label=False for undesirable
kto_dataset = [
    {"prompt": "What's 2+2?", "completion": "The answer is 4.", "label": True},
    {"prompt": "What's 2+2?", "completion": "It might be 5.", "label": False},
]

kto_config = KTOConfig(
    output_dir="./kto_output",
    beta=0.1,
    desirable_weight=1.0,        # Weight for good examples
    undesirable_weight=1.0,      # Weight for bad examples (increase for loss aversion)
    learning_rate=5e-7,
    max_length=2048,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    num_train_epochs=1,
    bf16=True,
)

trainer = KTOTrainer(
    model=model,
    ref_model=ref_model,  # Or None with LoRA
    args=kto_config,
    train_dataset=kto_dataset,
    tokenizer=tokenizer,
)
trainer.train()
何时选择 KTO
- 你有二值反馈,但没有匹配的 pair
- 大规模的生产点赞/点踩数据
- 某一类占主导(例如 90% 好、10% 坏)——KTO 对不平衡的处理更好
- 带噪声标签的快速迭代(比 DPO 对噪声更鲁棒)
IPO ——Identity Preference Optimization
动机
DPO 存在一个退化解:只要把 chosen 与 rejected 之间的 margin 变得无限大,就能取得零 loss。实践中这意味着 DPO 过拟合——把 chosen 的概率推到 1、rejected 推到 0,记住训练数据。
IPO 的修正[14]:不用会饱和的 log-sigmoid,而使用平方 loss,其目标是某个特定的 margin。loss 在有限的间隔处取到最小,而非在无穷处。
Loss 函数
TRL 实现
下面给出一个基于 HuggingFace TRL 的最小可运行示例。
from trl import DPOConfig, DPOTrainer

# IPO is implemented as a DPO loss_type variant in TRL
ipo_config = DPOConfig(
    output_dir="./ipo_output",
    beta=0.1,
    loss_type="ipo",             # The key difference!
    learning_rate=5e-7,
    max_length=2048,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=8,
    bf16=True,
    num_train_epochs=1,
)

trainer = DPOTrainer(
    model=model, ref_model=None, args=ipo_config,
    train_dataset=pref_dataset, tokenizer=tokenizer, peft_config=lora_config,
)
trainer.train()
何时选择 IPO 而非 DPO
- 噪声偏好数据(众包标注、AI 评判有误)
- 观察到 DPO 过拟合(train loss 0,但 eval 退化)
- 想要更保守、更鲁棒的对齐
- 需要多个 epoch(DPO 在第 1 个 epoch 之后会退化;IPO 更稳定)
ORPO ——Odds Ratio Preference Optimization
动机
到目前为止的所有方法都需要一个参考模型——要么作为独立副本(显存翻倍),要么通过 LoRA 隐式提供。ORPO [141] 把 SFT 与偏好对齐结合在单一 loss 中,从而彻底消除了参考模型。
关键洞见:用生成 chosen 与 rejected 的几率比作为偏好信号。SFT 组件天然防止坍缩(无需 KL 正则化)。
Loss 函数
其中 。
TRL 实现
下面给出一个基于 HuggingFace TRL 的最小可运行示例。
from trl import ORPOConfig, ORPOTrainer

orpo_config = ORPOConfig(
    output_dir="./orpo_output",
    beta=0.1,                    # Odds ratio weight (lambda)
    learning_rate=5e-7,
    max_length=2048,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    bf16=True,
    num_train_epochs=1,
    gradient_checkpointing=True,
)

trainer = ORPOTrainer(
    model=model,                 # No ref_model needed!
    args=orpo_config,
    train_dataset=pref_dataset,  # Same format as DPO: prompt/chosen/rejected
    tokenizer=tokenizer,
    peft_config=lora_config,
)
trainer.train()
何时选择 ORPO
- 显存受限:无法承担参考模型副本(70B 模型可节省 70–140GB)
- 从 base model 开始(尚未做 SFT)——ORPO 同时完成 SFT
- 想要尽可能简单的流水线:一个模型、一个 loss、一次训练
- 从一开始就有好的偏好数据
Best-of-N 采样(拒绝采样)
动机
有时最简单的方法反而胜出。Best-of-N [262] 在 RL 阶段完全不需要训练——只需生成多个候选并挑出其中最好的一个。
算法
- 对每个 prompt,从 policy 生成 条响应(通常 –)
- 用 reward model 给所有响应打分
- 选择得分最高的响应
- (可选)把选中的响应用作下一轮迭代的 SFT 数据
TRL 实现
下面给出一个基于 HuggingFace TRL 的最小可运行示例。
from transformers import pipeline
import numpy as np

# Inference-time Best-of-N (manual implementation)
gen_pipeline = pipeline("text-generation", model=model, tokenizer=tokenizer)

def best_of_n(prompt, n=16, temperature=0.8):
    """Generate N candidates and return the highest-reward one."""
    candidates = gen_pipeline(
        prompt, num_return_sequences=n,
        temperature=temperature, do_sample=True, max_new_tokens=512,
    )
    scores = [reward_model.score(prompt, c["generated_text"]) for c in candidates]
    return candidates[np.argmax(scores)]["generated_text"]

best_response = best_of_n(prompt, n=16)

# Training: Rejection Sampling Fine-Tuning (RFT)
from trl import SFTConfig, SFTTrainer

# Step 1: Generate and filter
all_responses = []
for prompt in prompts:
    candidates = [generate(prompt, temp=0.9) for _ in range(16)]
    scores = [reward_model.score(prompt, c) for c in candidates]
    best_idx = np.argmax(scores)
    if scores[best_idx] > threshold:  # Quality gate
        all_responses.append({"prompt": prompt, "completion": candidates[best_idx]})

# Step 2: SFT on best responses
sft_config = SFTConfig(output_dir="./rft_output", learning_rate=2e-5, num_train_epochs=2, max_seq_length=2048)
trainer = SFTTrainer(model=model, args=sft_config, train_dataset=all_responses, tokenizer=tokenizer)
trainer.train()
# Step 3: Repeat from Step 1 with updated model (iterative RFT)
Best-of-N 的扩展律
质量收益成本说明1基线标准采样4+5–8% win-rate最低可用。成本/质量比良好16+10–15% win-rate很强。通常可媲美 PPO 的质量64+15–20% win-rate开始出现收益递减256+18–22% win-rate仅用于关键应用
总结:如何选择对齐方法
至此,我们已经完整考察了偏好优化与基于 RL 的对齐方法的整体图景。本节把关键权衡汇总成一份统一的参考,帮助从业者根据自己的约束条件选择合适的方案。
| 方法 | 模型 | 数据 | 算力 | 稳定性 | 最适合 |
|---|---|---|---|---|---|
| PPO | 4 | Online(生成) | 极高 | 低 | 极致质量、复杂推理 |
| GRPO | 2(无 critic) | Online(生成) | 高 | 中 | 数学/代码(可验证奖励) |
| DPO | 2 | Offline pair | 低 | 高 | 风格/安全、算力有限 |
| Online DPO | 3 | Online(生成) | 中 | 中–高 | 无分布偏移的 DPO |
| KTO | 2 | 未配对二值 | 低 | 高 | 生产反馈、点赞/点踩 |
| IPO | 2 | Offline pair | 低 | 极高 | 噪声标签、抗过拟合 |
| ORPO | 1 | Offline pair | 极低 | 高 | 显存受限、SFT 与对齐合一 |
| Best-of-N | 1+RM | Online(生成) | 中 | 完美 | 强基线、数据生成 |
表 8.1:各种对齐方法的跨方法对比。