
检索增强生成(Retrieval-Augmented Generation, RAG)[209] 已成为在生产环境中部署大型语言模型时最具实际影响力的技术之一。RAG 不再仅依赖训练时编码进模型权重中的知识,而是为 LLM 配备一个动态、可更新的外部记忆——使其能够在广泛的知识密集型任务中给出准确、有据可查且可验证的响应。
动机与问题陈述
参数化知识 vs. 非参数化知识
我们可以将两种知识来源之间的区别形式化。令 表示参数为 的语言模型, 为外部文档语料库。在每种范式下,给定查询 生成回答 的概率为:
其中 是关于文档的检索分布。RAG 对检索到的证据进行边缘化,使生成过程接地于非参数化知识。
何时选择 RAG vs. 微调 vs. 长上下文
| 标准 | RAG | 微调 | 长上下文 | RAG + 微调 |
|---|---|---|---|---|
| 知识频繁更新 | ✓ | ✓ | ||
| 需要引用 / 接地 | ✓ | ✓ | ✓ | |
| 专有大型语料库 | ✓ | ✓ | ||
| 适配风格 / 格式 | ✓ | ✓ | ||
| 教授新推理技能 | ✓ | ✓ | ||
| 语料库可放入上下文窗口 | ✓ | |||
| 要求低延迟 | ✓ |
表 16.1:决策指南:RAG vs. 微调 vs. 长上下文
核心 RAG 架构
一个标准的 RAG 系统由两个阶段构成:处理和存储文档的离线索引流水线,以及为查询提供服务的在线检索—生成流水线。
完整流水线图
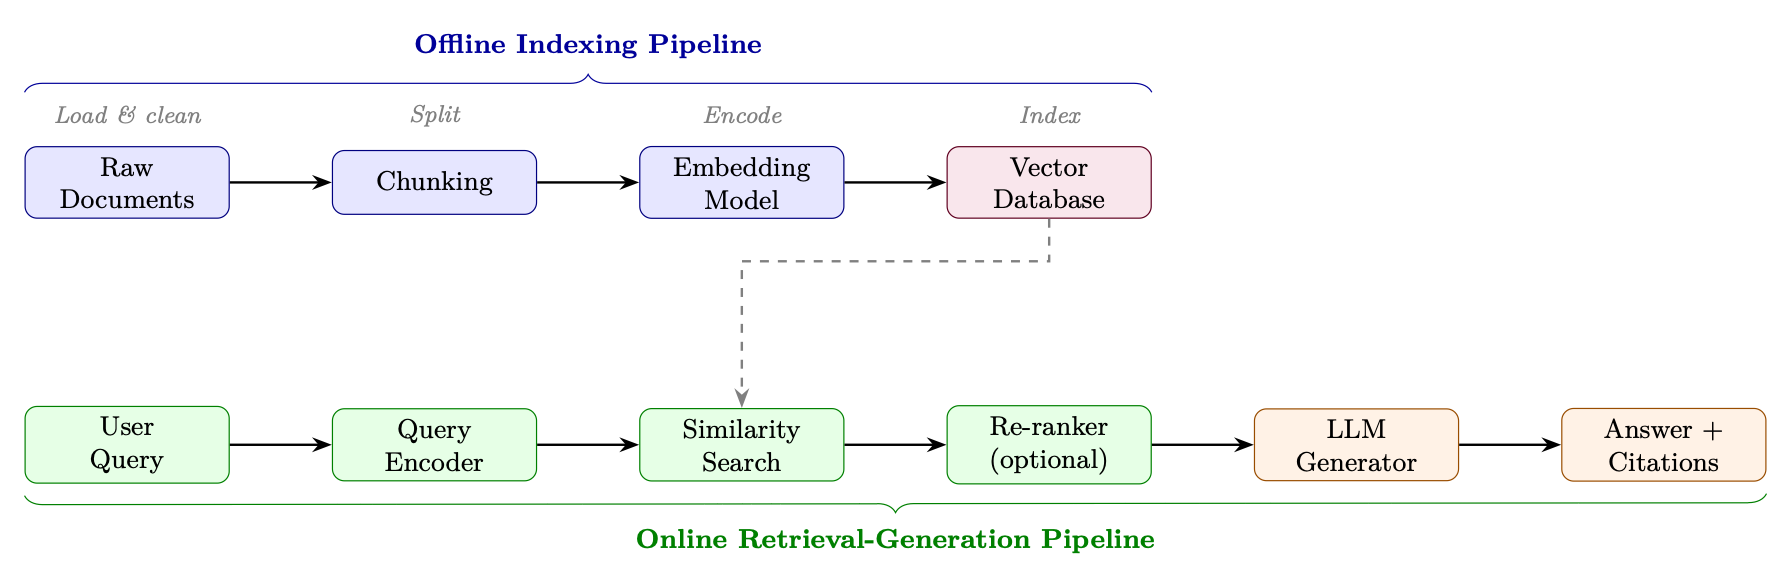
索引流水线
文档以异构格式抵达(PDF、HTML、Markdown、DOCX、代码)。加载器提取干净的文本,并保留元数据(来源 URL、页码、章节标题、时间戳),这些元数据会与 Embedding 一并存储,用于过滤和引用。
长文档必须切分成可放入 Embedding 模型上下文窗口(通常为 512 个 Token)并保持语义连贯的块。分块策略是 RAG 系统设计中影响最大的决策之一(参见第 16.4 分块策略 节)。
每个块 通过 Embedding 模型 编码为稠密向量 。这些向量与原始文本和元数据一同存储到向量数据库中。
检索
给定查询 ,检索步骤将其编码为 ,并通过余弦相似度找出最相似的 个块:
返回 top- 块 作为上下文。
生成
检索到的块被注入到一个 Prompt 模板中:
SYSTEM_PROMPT = """You are a helpful assistant. Answer the question using ONLY
the provided context. If the context does not contain enough information,
say so explicitly. Cite your sources using [Doc N] notation."""

def build_rag_prompt(query: str, chunks: list[dict]) -> str:
    context_str = "\n\n".join(
        f"[Doc {i+1}] (Source: {c['source']}, Page: {c.get('page','N/A')})\n{c['text']}"
        for i, c in enumerate(chunks)
    )
    return f"""{SYSTEM_PROMPT}

Context:
{context_str}

Question: {query}

Answer:"""
代码清单 8:标准 RAG Prompt 模板
检索方法
稀疏检索:BM25 与 TF-IDF
稀疏检索方法将文档和查询表示为词汇表上的高维稀疏向量。给定查询 (含词项 )时,针对文档 的经典 BM25 评分函数 [309] 为:
其中 为词频, 为文档长度,avgdl 为平均文档长度,、 为可调参数。
稠密检索:DPR
稠密段落检索(Dense Passage Retrieval, DPR)[180] 使用两个独立的 BERT 编码器——一个查询编码器 和一个段落编码器——通过对比损失训练,使相关的查询—段落对在 Embedding 空间中彼此靠近。
给定一批 个查询—段落对 ,对比损失将批内所有其他段落都视为负样本:
其中 是 temperature 超参数。难负样本(字面相似但语义无关的段落)对于训练强检索器至关重要。
在大规模场景下,对数百万个 Embedding 做穷举搜索是不可行的。FAISS [171](Facebook AI Similarity Search)提供高效的近似最近邻(ANN)搜索,具体方式包括:
- IVF(倒排文件索引):将向量聚类到 Voronoi 单元中;只搜索邻近的单元
- HNSW(分层可导航小世界)[248]:基于图的索引,支持 搜索
- PQ(乘积量化):压缩向量以减少内存占用
基于倒数排名融合的混合检索
混合检索结合稀疏分数与稠密分数。一种简单的线性组合为:
然而,来自不同系统的分数无法直接比较。互逆排名融合(Reciprocal Rank Fusion, RRF)[62] 通过基于排名而非分数来规避这一问题:
其中 是排序列表的集合(例如 BM25 排名与稠密排名), 是文档 在列表 中的排名, 是平滑常数,用于降低排名极高的文档所带来的影响。
学习式稀疏检索:SPLADE 与 SPLADEv2
SPLADE(Sparse Lexical and Expansion Model)[95] 使用预训练的掩码语言模型(MLM,例如 BERT/DistilBERT)为每个文档或查询生成一个覆盖整个词汇表的稀疏向量。关键洞见在于:MLM 头已经知道文本中每个位置与哪些词在语义上相关——SPLADE 把这一知识重新用作词项重要性权重。
给定输入文本 :
- 经过 Transformer 编码器,通过 MLM 头获得上下文表示
- 在所有位置上进行聚合,并施加饱和激活:
其中 是输入位置 处词汇表 Token 的 MLM logit。
- 饱和可防止任何单个词项占据主导(类似 BM25 中的 TF 饱和)
- ReLU 保证了稀疏性——大多数词汇表词项的权重为零
- 跨位置的 池化会为每个词项捕捉来自文本任意位置的最强信号
- 扩展:即使未出现在原始文本中的 Token 也能获得非零权重(例如,一篇关于「neural networks」的文档可能获得「deep learning」「AI」「backpropagation」的权重)
查询和文档分别映射为稀疏向量 。相关性得分就是简单的点积:
由于两个向量都是稀疏的(在 30K 的词汇表中通常只有 20–200 个非零项),这可以用标准的倒排索引(Lucene、Anserini)高效计算——查询时无需 GPU。
SPLADE 使用对比学习(批内负样本 + 难负样本)训练,并额外加入两个正则项:
对查询和文档表示的 惩罚促进稀疏性——没有它们,模型会学到稠密表示,从而违背初衷。
SPLADEv2 [94] 引入了若干改进,显著提升了效率与效果:
- 从交叉编码器蒸馏:SPLADEv2 不再仅使用二元相关性标签训练,而是采用交叉编码器教师(例如 MonoT5 [269])提供软相关性分数。这带来了更丰富的训练信号:(16.12)
- 查询与文档使用独立编码器:SPLADEv2 对查询和文档采用不同的稀疏度目标。查询被鼓励更加稀疏(查找更快),而文档可以稍稠密一些(离线预先计算):(16.13)
- FLOPs 正则化:SPLADEv2 不再使用简单的 ,而是引入感知 FLOPs 的正则项,直接惩罚预期的检索开销:(16.14)其中 是词项 在整个 batch 上的平均激活值。这会惩罚在大量文档中都非零的词项(倒排列表越长 = 检索越慢)。
- 高效骨干网络:使用 DistilBERT(66M 参数)而非 BERT-base(110M 参数),在质量损失极小的前提下将编码时间减半。
ColBERT:晚期交互
ColBERT [183] 将查询和文档编码为 Token 级 Embedding 的集合,并使用 MaxSim 算子进行打分:
这种后期交互(late interaction)机制比单向量双编码器更具表现力,同时因为文档 Embedding 是离线预先计算的,它又远比交叉编码器快。
查询编码器 和文档编码器 都是基于 BERT 的模型,产生逐 Token的 Embedding(而不是单个 [CLS] 向量)。每个 Token 的 Embedding 通过一个线性层投影到更低的维度(通常为 128):
ColBERT 使用针对正、负段落的成对 softmax 交叉熵损失进行训练。给定查询 、正段落 和一组负段落 :
其中 是式 16.15 中的 MaxSim 分数。负样本来自:
- 批内负样本:同一训练 batch 中的其他段落(免费且数量充足)
- 难负样本:由 BM25 检索出的、字面相似但语义无关的段落(对质量影响最大)
- 蒸馏负样本(ColBERTv2 [313]):使用交叉编码器教师挖掘最难的负样本,并将其分数蒸馏进 ColBERT
在索引阶段,所有文档 Token 的 Embedding 都会被预先计算并存储(ColBERTv2 中可选地通过残差量化进行压缩)。在查询阶段,只有查询 Token 需要实时编码,MaxSim 针对已存储的文档 Embedding 计算。这种分离带来了:
- 离线文档编码:编码一次,服务大量查询
- PLAID 索引[313]:对文档 Embedding 聚类,用质心做初步候选检索,然后只对候选计算精确的 MaxSim——将延迟降低 5–10
- 索引大小:每个文档 个浮点数(比单向量方法更大,但通过量化可压缩到每维 2 字节)
检索方法对比
| 方法 | 延迟 | 准确率 | 索引大小 | GPU | 最适合 |
|---|---|---|---|---|---|
| TF-IDF [336] | 极低 | 低 | 小 | 否 | 基线、精确匹配 |
| BM25 [309] | 极低 | 中 | 小 | 否 | 关键词搜索、罕见词项 |
| DPR / 双编码器 [180] | 低 | 高 | 大 | 是 | 语义相似度 |
| SPLADE [95] | 低 | 高 | 中 | 是 | 准确率与速度兼得 |
| ColBERT [183] | 中 | 很高 | 很大 | 是 | 高准确率检索 |
| 交叉编码器 [268] | 高 | 最高 | 不适用 | 是 | 对 top- 重排 |
| 混合(RRF)[62] | 低 | 很高 | 大 | 是 | 生产系统 |
表 16.2:各检索方法在关键维度上的对比
分块策略
分块是将文档切分为若干片段的过程,这些片段(1)足够小,可以放入 Embedding 模型的上下文窗口,(2)语义连贯,并且(3)在单独被检索出来时包含足够有用的上下文。
带重叠的固定大小分块
最简单的策略:每 个 Token 切分一次,相邻块之间重叠 个 Token。
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=512,       # tokens per chunk
    chunk_overlap=64,     # overlap to preserve context across boundaries
    length_function=len,
    separators=["\n\n", "\n", ". ", " ", ""]
)
chunks = splitter.split_documents(documents)
代码清单 9:带重叠的固定大小分块
重叠公式:对于长度为 个 Token 的文档,块的数量为:
语义分块
语义分块不在固定间隔处切分,而是在通过测量相邻句子之间的 Embedding 相似度检测出的主题边界处切分:
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

chunker = SemanticChunker(
    embeddings=OpenAIEmbeddings(),
    breakpoint_threshold_type="percentile",  # or "standard_deviation"
    breakpoint_threshold_amount=95,          # split at top 5% dissimilarity
)
chunks = chunker.split_documents(documents)
代码清单 10:基于 Embedding 相似度的语义分块
基于文档结构的分块
对于结构化文档(Markdown、HTML、代码),在自然边界处切分:
- Markdown:在
##标题处切分,保留章节上下文 - HTML:在
⟨section⟩、⟨article⟩、⟨p⟩标签处切分 - 代码:在函数/类定义处切分,并在每个块中保留 import
- 表格:整张表作为单个块保留;绝不在行中间切分
父—子分块
一种将检索粒度与生成上下文解耦的强大模式:
- 索引小的子块(例如 128 个 Token)以进行精确检索
- 返回大的父块(例如 512 个 Token)给 LLM 以获得更丰富的上下文
from langchain.retrievers import ParentDocumentRetriever
from langchain.storage import InMemoryStore
from langchain.text_splitter import RecursiveCharacterTextSplitter

parent_splitter = RecursiveCharacterTextSplitter(chunk_size=2000)
child_splitter  = RecursiveCharacterTextSplitter(chunk_size=400)

retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=InMemoryStore(),
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)
retriever.add_documents(documents)
代码清单 11:使用 LangChain 的父子分块
块大小的经验指南
| 用例 | 建议块大小 | 重叠 |
|---|---|---|
| 事实型问答(精确事实) | 128–256 个 Token | 20–32 个 Token |
| 摘要 / 综合 | 512–1024 个 Token | 64–128 个 Token |
| 代码检索 | 完整函数 | 无 |
| 法律 / 监管文档 | 段落级 | 1 个句子 |
| 对话 / 聊天 | 256–512 个 Token | 32–64 个 Token |
表 16.3:按用例划分的块大小建议
高级 RAG 模式
查询变换
原始用户查询往往含糊、过短,或者与文档用语匹配不佳。查询变换技术在搜索步骤之前改进检索。
与其直接对查询做 Embedding,不如生成一个假设性答案,再对它做 Embedding:
其直觉是:假设性答案与真实文档处于相同的语言语域,从而缩小查询与文档之间的分布差距。
对于具体问题,先生成一个更通用的「后退」问题,对两者都做检索,再合并上下文。例如:「乙醇在 2 atm 下的沸点是多少?」 后退:「哪些因素会影响液体的沸点?」
生成 个多样化的查询改写,对每个都做检索,再取结果的并集:
from langchain.retrievers.multi_query import MultiQueryRetriever
from langchain_openai import ChatOpenAI

retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 5}),
    llm=ChatOpenAI(temperature=0.7),
    include_original=True,   # also retrieve for original query
)
# Internally generates 3 query variants, retrieves for each, deduplicates
docs = retriever.get_relevant_documents(query)
代码清单 12:多查询检索
重排序
在初步检索出 top- 候选之后,交叉编码器重排器会联合地为每个查询—文档对打分(同时关注两者),以更高的延迟为代价给出准确得多的相关性分数:
交叉编码器无法用于第一阶段检索(没有预先计算的文档 Embedding),但非常适合对一小批候选(通常为 – 个)进行重排。
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-large")

def rerank(query: str, docs: list[str], top_n: int = 5) -> list[str]:
    pairs = [(query, doc) for doc in docs]
    scores = reranker.predict(pairs)
    ranked = sorted(zip(scores, docs), reverse=True)
    return [doc for _, doc in ranked[:top_n]]
代码清单 13:使用 BGE 的交叉编码器重排
上下文压缩
检索到的块往往在相关段落周围夹杂着无关句子。上下文压缩使用 LLM 只抽取相关的部分:
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import LLMChainExtractor

compressor = LLMChainExtractor.from_llm(llm)
compression_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=vectorstore.as_retriever()
)
compressed_docs = compression_retriever.get_relevant_documents(query)
代码清单 14:基于 LLM 的上下文压缩
Self-RAG
Self-RAG [13] 训练单个模型来(1)决定是否要检索,(2)在有或没有检索的情况下生成,(3)使用特殊的反思 Token 批判自己的输出:
[Retrieve]:模型是否应该检索更多段落?[IsRel]:检索到的段落是否与查询相关?[IsSup]:生成的陈述是否由检索到的段落推出?[IsUse]:整体回答是否有用?
模型经过端到端训练,在生成回答的同时预测这些 Token,从而实现对检索与自评的细粒度控制。
CRAG:纠正式 RAG
CRAG [401] 增加了一个检索评估器,对检索到的文档进行评级并触发纠正动作:
- 检索 top- 文档
- 为每个文档评级:正确 / 模糊 / 错误
- 如果所有文档都不正确或模糊 回退到网页搜索
- 如果部分文档正确 使用知识精炼(剔除无关句子)
- 基于精炼后的上下文生成回答
自适应 RAG
自适应 RAG [162] 根据预测的复杂度将查询路由到不同的检索策略:
- 不检索:模型仅凭参数即可回答的简单事实性查询
- 单步 RAG:针对中等难度查询的标准「先检索后生成」
- 多步 RAG:针对复杂多跳问题的迭代检索
一个在查询复杂度标签上训练的轻量级分类器会为每个到来的查询选择路由。
Graph RAG
微软的 Graph RAG [82] 从文档语料库构建知识图谱,并使用社区检测生成层级式摘要:
- 实体抽取:LLM 从每个块中抽取实体与关系
- 图构建:构建一个图 ,其中节点是实体、边是关系
- 社区检测:应用 Leiden 算法在多个分辨率上发现社区
- 社区摘要:LLM 为每个社区生成一段摘要
- 查询:对于全局查询,在社区摘要上做 map-reduce;对于局部查询,使用标准向量搜索
RAG-Fusion
RAG-Fusion [300] 从原始查询生成多个搜索查询,对每个都做检索,并使用 RRF(式 16.8)融合各个排序列表:
def reciprocal_rank_fusion(ranked_lists: list[list[str]], k: int = 60) -> list[str]:
    """Fuse multiple ranked document lists using RRF."""
    scores: dict[str, float] = {}
    for ranked in ranked_lists:
        for rank, doc_id in enumerate(ranked, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)

def rag_fusion(query: str, retriever, llm, n_queries: int = 4) -> str:
    # Step 1: Generate query variants
    variants = generate_query_variants(query, llm, n=n_queries)
    # Step 2: Retrieve for each variant
    all_ranked = [retriever.retrieve(q) for q in [query] + variants]
    # Step 3: Fuse with RRF
    fused_docs = reciprocal_rank_fusion(all_ranked)
    # Step 4: Generate answer
    return generate_answer(query, fused_docs[:5], llm)
代码清单 15:使用 RRF 的 RAG-Fusion
高效 RAG 解码:REFRAG
RAG 的一个实际瓶颈是解码延迟:拼接进 LLM 上下文的检索段落往往很长却只有稀疏的相关性,抬高了首 Token 时间(TTFT)和 KV cache 内存占用。REFRAG [221] 观察到,由于检索段落各自来源独立(重排时经过多样性筛选或去重),它们的 attention 模式呈块对角——大多数跨段落的 attention 接近零。这种稀疏性意味着解码过程中对 RAG 上下文的大部分计算都是不必要的。
REFRAG 通过一个三阶段解码策略来利用这一结构:
- 压缩:用紧凑的摘要(例如每个段落块的均值池化 key/value)替换检索段落的完整 KV 表示,大幅降低内存占用。
- 感知:在每个解码步,对压缩后的表示施加轻量 attention,以确定哪些段落块与当前 Token 相关。
- 扩展:只为被选中的块重建完整的 KV 条目,在稀疏的活跃集合上执行精确 attention。
在基于 LLaMA 的模型上,REFRAG 实现了最高 的 TTFT 加速(相比此前的稀疏 attention 基线提升 ),且困惑度没有任何损失。在固定内存预算下,它还把有效上下文长度扩展了 。这些收益在 RAG、多轮对话和长文档摘要任务中均成立。
智能体 RAG
动机:静态 RAG 的局限
标准 RAG 遵循固定的「先检索后生成」模式。它在以下情况会失效:
- 多跳问题:「2023 年收购了 OpenAI 主要竞争对手的那家公司是谁创立的?」需要串联多次检索
- 含糊查询:正确的检索策略取决于检索到了什么
- 异构来源:不同的子问题需要不同的知识库
- 迭代式精炼:初步检索可能揭示出需要换一个查询
智能体 RAG 架构
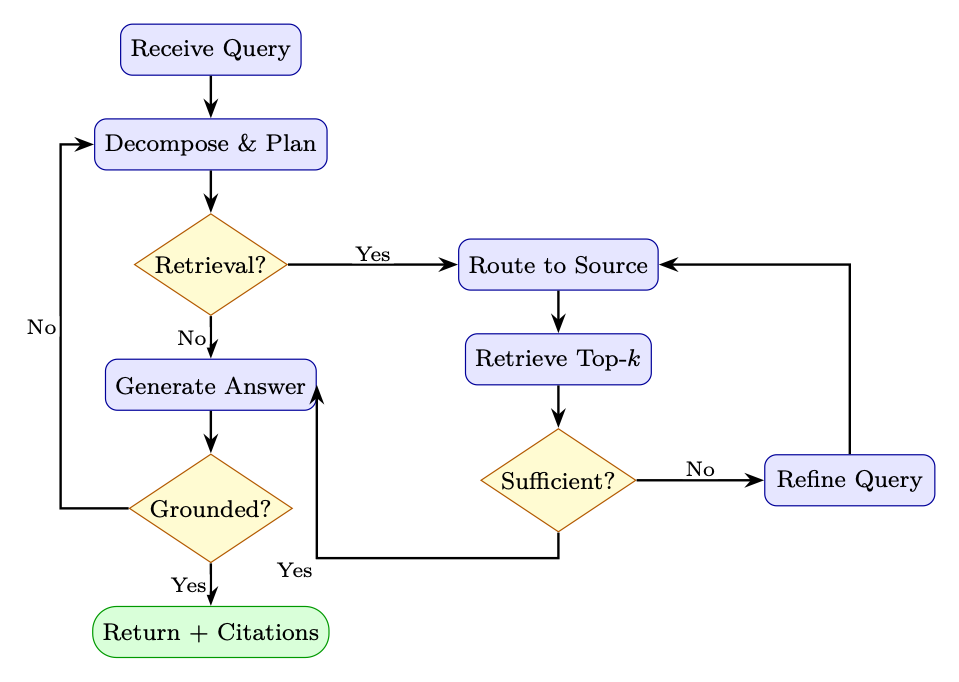
多源路由
智能体 RAG 系统可以把子查询路由到专门的知识源。核心洞见在于:不同的问题类型需要不同的检索后端——没有任何单一索引能在所有方面都表现出色。
设想一个为金融分析师服务的助手处理四个查询:
- “我们公司的带薪休假(PTO)政策是什么?” 向量数据库(内部文档)
- “美联储昨天宣布了什么?” 网页搜索(实时)
- “按地区展示 Q3 营收” SQL 数据库(结构化数据)
- “我们的鉴权中间件如何校验 Token?” 代码索引(代码库)
“从单一索引扁平化检索”的做法要么错过答案,要么返回无关段落。路由在检索开始前,为合适的子问题选择合适的工具。
三种主要方法,按复杂度递增:
- 基于规则的路由。通过关键词触发(例如,SQL 关键字 数据库,URL 模式 网页)。快速且可解释,但对歧义查询非常脆弱。
- 基于分类器的路由。由一个轻量模型(如微调过的 BERT 分类器,或在查询 Embedding 上的逻辑回归)预测最佳来源。延迟低(10 毫秒),可基于路由日志训练,但需要带标签数据。
- 基于 LLM 的路由。LLM 本身在一次结构化输出调用中决定来源(见下面的代码清单)。最为灵活——可以处理新颖的查询类型并解释其推理——但会增加一次 LLM 调用的延迟。
- 回退链:若主要来源返回的结果置信度较低,则尝试次优来源。
- 并行扇出:对于歧义查询,同时从多个来源检索,并通过互逆排名融合(表 表 16.2)合并结果。
- 成本感知:网页搜索和 API 调用可能存在金钱开销或速率限制;路由器应将其纳入考量。
- 可观测性:记录每个路由决策及其推理过程——对调试和再训练至关重要。
from enum import Enum
from pydantic import BaseModel

class KnowledgeSource(str, Enum):
    VECTOR_DB   = "vector_db"    # internal documents
    WEB_SEARCH  = "web_search"   # real-time web
    SQL_DB      = "sql_db"       # structured data
    CODE_INDEX  = "code_index"   # codebase
    API         = "api"          # external APIs

class RouteDecision(BaseModel):
    source: KnowledgeSource
    refined_query: str
    reasoning: str

def route_query(query: str, llm) -> RouteDecision:
    """Use LLM to decide which knowledge source to query."""
    prompt = f"""Given the query: "{query}"

Decide which knowledge source to use:
- vector_db: for internal documents, policies, past reports
- web_search: for current events, recent information
- sql_db: for numerical data, statistics, structured records
- code_index: for code examples, API documentation
- api: for real-time data (weather, stock prices, etc.)

Return a JSON with: source, refined_query, reasoning."""

    return llm.with_structured_output(RouteDecision).invoke(prompt)
代码清单 16:多源智能体 RAG 路由器
完整的智能体 RAG 实现
前面几节介绍了各个独立组件——路由、检索、评估。一个完整的智能体 RAG 系统将它们编排为一个有状态节点的图,其中控制流取决于中间结果。下面的实现使用 LangGraph 将四个节点串成一个循环:
- 计划(Plan):将用户查询分解为子查询(每个信息需求对应一个)。
- 检索(Retrieve):将每个子查询路由到合适的来源并取回文档。
- 评估(Evaluate):判断累积的上下文是否足以回答原始查询。
- 生成(Generate):综合检索到的文档生成带引用的最终答案。
关键设计模式是条件循环:评估之后,智能体要么进入生成阶段(如果上下文足够,或迭代预算耗尽),要么带着精炼后的子查询回到检索阶段。这与一个在信息收集动作上运行的 RL 智能体所遵循的“感知—行动—评估”循环如出一辙。
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import ToolNode
import operator

class AgentState(TypedDict):
    query: str
    sub_queries: list[str]
    retrieved_docs: Annotated[list[dict], operator.add]
    context_sufficient: bool
    answer: str
    iterations: int
    max_iterations: int

def plan_node(state: AgentState) -> AgentState:
    """Decompose query into sub-queries."""
    sub_queries = decompose_query(state["query"])
    return {**state, "sub_queries": sub_queries, "iterations": 0}

def retrieve_node(state: AgentState) -> AgentState:
    """Retrieve documents for current sub-queries."""
    new_docs = []
    for sq in state["sub_queries"]:
        source = route_query(sq)
        docs = retrieve_from_source(sq, source)
        new_docs.extend(docs)
    return {**state, "retrieved_docs": new_docs,
            "iterations": state["iterations"] + 1}

def evaluate_node(state: AgentState) -> AgentState:
    """Evaluate whether retrieved context is sufficient."""
    sufficient = evaluate_context_sufficiency(
        query=state["query"],
        docs=state["retrieved_docs"]
    )
    return {**state, "context_sufficient": sufficient}

def generate_node(state: AgentState) -> AgentState:
    """Generate answer from retrieved context."""
    answer = generate_with_citations(
        query=state["query"],
        docs=state["retrieved_docs"]
    )
    return {**state, "answer": answer}

def should_retrieve(state: AgentState) -> str:
    if state["context_sufficient"]:
        return "generate"
    if state["iterations"] >= state["max_iterations"]:
        return "generate"  # give up and generate with what we have
    return "retrieve"

# Build the graph
workflow = StateGraph(AgentState)
workflow.add_node("plan",     plan_node)
workflow.add_node("retrieve", retrieve_node)
workflow.add_node("evaluate", evaluate_node)
workflow.add_node("generate", generate_node)

workflow.set_entry_point("plan")
workflow.add_edge("plan",     "retrieve")
workflow.add_edge("retrieve", "evaluate")
workflow.add_conditional_edges("evaluate", should_retrieve,
    {"retrieve": "retrieve", "generate": "generate"})
workflow.add_edge("generate", END)

agent = workflow.compile()

# Run
result = agent.invoke({
    "query": "What were the main causes of the 2023 banking crisis?",
    "max_iterations": 3,
    "retrieved_docs": [],
    "iterations": 0,
})
代码清单 17:基于 LangGraph 的智能体 RAG
工具增强的 RAG
智能体 RAG 可以将检索与计算工具结合起来:
from langchain.agents import create_tool_calling_agent, AgentExecutor
from langchain.tools import tool

@tool
def search_documents(query: str) -> str:
    """Search internal document knowledge base."""
    docs = vectorstore.similarity_search(query, k=5)
    return "\n\n".join(d.page_content for d in docs)

@tool
def query_database(sql: str) -> str:
    """Execute SQL query on the analytics database."""
    return db.run(sql)

@tool
def web_search(query: str) -> str:
    """Search the web for current information."""
    return tavily_client.search(query)

@tool
def execute_python(code: str) -> str:
    """Execute Python code for calculations."""
    return python_repl.run(code)

tools = [search_documents, query_database, web_search, execute_python]
agent = create_tool_calling_agent(llm, tools, prompt)
executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
代码清单 18:结合 SQL 与检索的工具增强 RAG
Search-R1:RL 训练的智能体 RAG
上述智能体 RAG 方法依赖 Prompt 工程式编排——智能体的搜索行为由指令控制,而不是通过训练习得。Search-R1[170] 采取了根本不同的思路:它通过强化学习训练 LLM,使其把学会何时搜索、搜索什么、搜索多少次作为推理过程的一部分。
Search-R1 扩展了 DeepSeek-R1 [69] 推理框架,把搜索引擎查询视为 RL 训练循环中的动作。在思维链生成过程中,模型可以发出特殊 token <search>query</search>,触发从搜索引擎的实时检索。检索结果被注回推理上下文,模型继续生成。
模型生成与搜索动作交织的推理轨迹:
整条轨迹(推理 + 搜索 + 最终答案)由终局奖励打分:即最终答案相对于标准答案标签(ground-truth label)的正确性。
Search-R1 使用 GRPO(组相对策略优化):
- 为每个问题采样 条轨迹,每条轨迹可能包含 0–5 次搜索调用
- 实时执行搜索——环境返回真实的搜索引擎结果
- 对终局答案的正确性打分(与标准答案比对,使用精确匹配或 F1)
- 计算组相对优势:
- 更新策略:使用 GRPO 的裁剪目标——强化搜索有效的轨迹
模型学会:
- 在不确定时搜索——避免为已掌握的知识进行不必要的搜索
- 构造有效的查询——学会能返回相关结果的查询措辞
- 多次搜索——基于初始结果迭代精炼查询
- 整合检索到的上下文——用搜索结果支撑或修正自己的推理
| 维度 | 基于 Prompt 的智能体 RAG | Search-R1 |
|---|---|---|
| 搜索决策 | Prompt/启发式规则 | 通过 RL 学习得到 |
| 查询构造 | 由 Prompt 引导(“改写查询”) | 端到端训练 |
| 搜索次数 | 固定,或在推理时由 LLM 决定 | 学习得到的最优次数 |
| 训练信号 | 无(模型冻结) | 正确性奖励 |
| 搜索集成方式 | 追加到上下文 | 交织在思维链中 |
| 失败恢复 | 重试启发式规则 | 学习得到的退避/重构策略 |
| 推理时的额外开销 | 框架开销(LangGraph) | 模型原生行为 |
表 16.4:Search-R1(RL 训练)与基于 Prompt 的智能体 RAG 对比。
在开放域问答基准(NQ [195]、TriviaQA [173]、HotpotQA [406])上,使用 7B 模型的 Search-R1 优于:
- 标准 RAG(单次检索),准确率高出 15–20%
- Prompt 引导的智能体 RAG(ReAct 风格),准确率高出 8–12%
- 接近使用标准 RAG 的更大模型(70B)的性能
关键洞见:学会何时搜索以及如何搜索,比拥有一个知道更多的更大模型更有价值。一个善于搜索的小模型胜过一个不搜索的大模型。
评测
评估一个 RAG 系统比孤立地评估检索或生成更难,因为错误可能源自流水线的任何阶段——而且它们会叠加。完美的生成器无法弥补无关的检索结果;而如果生成器产生幻觉或忽略上下文,再完美的检索器也是白费。
因此,有效的 RAG 评估在三个层面上展开:
- 检索质量:检索器是否找出了正确的段落?(召回率、精确率、MRR、NDCG)
- 生成质量:答案是否正确、是否忠实于检索到的上下文、是否完整?(正确性、忠实性、答案相关性)
- 端到端质量:整个系统是否令用户满意?(人类偏好、任务成功率、经延迟调整的效用)
一种常见的失败模式是只优化一个层面——例如,用较大的 来最大化 Recall@,会让上下文塞满边缘相关的段落,反而降低生成质量。下面的指标同时覆盖检索与生成,使实践者能够诊断哪一阶段是瓶颈。
检索指标
令 为排名前 的检索文档集合, 为相关文档集合。
其中 是查询 的第一个相关文档的排名。
其中 是第 个结果的分级相关性,IDCG 是理想的(完美的)DCG。
生成指标
衡量生成的答案是否有据可依地扎根于检索到的上下文——即答案中的每一项断言都能归因到某篇检索文档。由 LLM 评判器评估:
衡量答案是否回应了问题。做法是由答案反向生成问题,并度量其与原始查询的相似度:
其中 是由答案生成的问题。
RAGAs 框架
RAGAs(Retrieval Augmented Generation Assessment)[85] 提供了使用 LLM 评判器的无参考评估框架:
from ragas import evaluate
from ragas.metrics import (
    faithfulness,
    answer_relevancy,
    context_precision,
    context_recall,
    answer_correctness,
)
from datasets import Dataset

eval_dataset = Dataset.from_dict({
    "question":  questions,
    "answer":    generated_answers,
    "contexts":  retrieved_contexts,   # list of lists
    "ground_truth": reference_answers,
})

results = evaluate(
    dataset=eval_dataset,
    metrics=[
        faithfulness,
        answer_relevancy,
        context_precision,
        context_recall,
        answer_correctness,
    ],
)
print(results.to_pandas())
代码清单 19:RAGAs 评估(v0.1 API;v0.2+ 使用 user_input、response、retrieved_contexts、reference)
常见失败模式
生产考量
Embedding 模型选型
Embedding 模型是 RAG 系统中影响最大的单项组件选择——它决定了检索的质量上限。该领域发展迅速;表 表 16.5 汇总了当前在成本—质量谱系上的可选方案。
| 模型 | 维度 | 最大 Token 数 | MTEB 均值 | 访问方式 | 备注 |
|---|---|---|---|---|---|
| 基于 API(托管) | |||||
| Voyage voyage-4-large | 1024* | 32K | — | API | 最佳检索质量 |
| OpenAI text-embedding-3-large | 3072 | 8191 | 64.6 | API | 套娃式维度 |
| Cohere embed-english-v3.0 | 1024 | 512 | 64.5 | API | 支持 int8/二进制 |
| Google text-embedding-005 | 768 | 2048 | — | API | Vertex AI 集成 |
| 开放权重(自托管) | |||||
| nvidia/NV-Embed-v2[203] | 4096 | 32K | 72.3 | 免费 | #1 MTEB(2024 年 9 月) |
| Alibaba-NLP/gte-Qwen2-7B[214] | 3584 | 32K | 70.2 | 免费 | Apache-2.0,多语言 |
| BAAI/bge-m3[45] | 1024 | 8192 | 65.0 | 免费 | 稠密 + 稀疏 + 多向量 |
| jinaai/jina-embeddings-v3 | 1024 | 8192 | 66.0 | 免费 | 多语言,LoRA 适配器 |
| BAAI/bge-large-en-v1.5[395] | 1024 | 512 | 64.2 | 免费 | 成熟,支持完善 |
表 16.5:用于生产级 RAG 的 Embedding 模型(截至 2026 年)。MTEB 分数是检索、分类、聚类与 STS 任务上的总体平均值。
- 领域匹配:专用模型(例如用于代码的
voyage-code-3、用于金融的voyage-finance-2)在领域任务上可以比通用模型高出 5–15%。 - 上下文长度:具有 32K Token 上下文的模型(Voyage-4、NV-Embed-v2)可以嵌入整篇文档而无需分块,从而简化流水线。
- 套娃式维度嵌入(Matryoshka embeddings):支持灵活输出维度(256–4096)的模型让你可以在服务时用质量换取存储/延迟,而无需重新编码。
- 量化支持:模型层面的 int8 或二进制量化(Cohere、Voyage)可将索引大小减少 4–32,而召回损失极小。
- 多语言:对于非英语或跨语言 RAG,优先选择明确以多语言训练的模型(BGE-M3、Jina-v3、Voyage-4)。
向量数据库对比
| 数据库 | 托管方式 | 规模 | 过滤 | 混合检索 | 适用场景 |
|---|---|---|---|---|---|
| FAISS1 | 自托管 | 数十亿 | 有限 | 否 | 研究、离线 |
| Pinecone2 | 托管 | 数十亿 | 是 | 是 | Serverless,易于搭建 |
| Weaviate3 | 两者皆可 | 数十亿 | 是 | 是 | GraphQL,多模态 |
| Chroma4 | 自托管 | 百万级 | 是 | 否 | 本地开发、原型验证 |
| Qdrant5 | 两者皆可 | 数十亿 | 是 | 是 | 高性能 |
| Milvus6 | 两者皆可 | 数十亿 | 是 | 是 | 企业级,GPU 加速 |
| pgvector7 | 自托管 | 百万级 | 是 | 是 | 现有 Postgres 用户 |
表 16.6:面向生产级 RAG 系统的向量数据库对比
5https://qdrant.tech 6https://milvus.io 7https://github.com/pgvector/pgvector
延迟优化
- 预过滤:在 ANN 搜索之前使用元数据过滤(日期范围、类别、来源)来缩小搜索空间
- 近似最近邻(Approximate NN):使用 HNSW 或 IVF 索引替代精确搜索;以 1% 的召回损失换取 的加速
- Embedding 缓存:缓存频繁重复查询的嵌入
- 异步检索:并行从多个来源检索
- 流式生成:在检索完成的同时流式输出 LLM 结果
- 量化:对嵌入使用 int8 或二进制量化,以降低内存占用并提高吞吐量
上文的技术(3)和(4)可以自然组合:先缓存查询嵌入,再把检索请求并发扇出到多个后端。在多源 RAG 系统(第 16.7 智能体 RAG 节)中,用户查询可能需要来自向量数据库、关键词索引和网页 API 的结果。串行检索会累加延迟;并行检索只需付出最慢来源的代价。代码清单 使用 Python 的 asyncio 演示了这一模式——lru_cache 装饰器确保重复查询完全跳过嵌入模型,而 asyncio.gather 则同时派发所有来源查询。
import asyncio
from functools import lru_cache

@lru_cache(maxsize=1024)
def get_cached_embedding(text: str) -> list[float]:
    return embedding_model.embed_query(text)

async def parallel_retrieve(
    query: str,
    sources: list[str],
    k: int = 5
) -> list[dict]:
    """Retrieve from multiple sources in parallel."""
    tasks = [
        asyncio.create_task(retrieve_from_source_async(query, src, k))
        for src in sources
    ]
    results = await asyncio.gather(*tasks, return_exceptions=True)
    # Flatten and deduplicate
    all_docs = []
    for r in results:
        if not isinstance(r, Exception):
            all_docs.extend(r)
    return deduplicate_by_content(all_docs)
代码清单 20:面向低延迟的异步并行检索
增量索引与版本管理
在生产环境中,文档语料库从不是静态的——政策会被修订,新报告每天入库,过时内容必须移除。全量重建索引(重新分块、重新嵌入、重新上传)代价高昂且会导致服务中断。增量索引通过在文档级别应用变更来解决这一问题。
- Upsert:当文档被创建或更新时,删除该
doc_id的所有现有分块,再对新内容重新分块、嵌入并插入。这保证不会残留过期片段。 - 删除/过期:按文档 ID 移除分块(显式删除),或按 TTL 移除(对新闻、市场数据等时效性来源自动回收垃圾)。
- 版本追踪:在分块元数据中存储
version和indexed_at时间戳。这使得回滚(从来源恢复先前版本)与可审计性(“模型看到的是哪个版本?”)成为可能。
- Embedding 模型漂移:如果升级 Embedding 模型,新旧向量互不兼容。解决方案:(a) 为每个模型版本维护独立索引,并在后台迁移;或 (b) 使用兼容套娃式维度的模型,其维度截断可保持兼容性。
- 分块边界变化:更改分块策略会使所有现有分块失效。版本元数据让你能够识别并有选择地重建受影响文档的索引。
- 最终一致性:在分布式向量数据库中,新写入的向量可能无法立即被搜索到。设计流水线时要能容忍短暂的索引延迟(通常为几秒到几分钟)。
代码清单 21 展示了一个最小的 RAGIndexManager 类,封装了 upsert 与过期逻辑,适合包装任何支持元数据过滤的向量库。
class RAGIndexManager:
    def __init__(self, vectorstore, metadata_store, chunker, embedder):
        self.vs = vectorstore
        self.meta = metadata_store
        self.chunker = chunker
        self.embedder = embedder

    def upsert_document(self, doc_id: str, content: str,
                        metadata: dict) -> None:
        """Add or update a document, replacing old chunks."""
        # Delete existing chunks for this document
        self.vs.delete(filter={"doc_id": doc_id})
        # Chunk new version (vectorstore embeds internally)
        chunks = self.chunker.split_text(content)
        self.vs.add_texts(
            texts=chunks,
            metadatas=[{**metadata, "doc_id": doc_id,
                        "version": metadata.get("version", 1),
                        "indexed_at": datetime.utcnow().isoformat()}
                       for _ in chunks],
        )

    def expire_old_documents(self, ttl_days: int = 365) -> int:
        """Remove documents older than TTL."""
        cutoff = (datetime.utcnow() - timedelta(days=ttl_days)).isoformat()
        return self.vs.delete(filter={"indexed_at": {"$lt": cutoff}})
代码清单 21:带版本管理的增量索引更新
RAG 与微调的协同
何时将 RAG 与微调结合
微调与 RAG 解决的是互补的短板:
- 仅微调:模型学会风格与格式,但可能编造事实
- 仅 RAG:模型能够获取事实,但可能不知道如何最优地使用它们
- 两者结合:微调模型,使其善用检索到的上下文——引用来源、承认不确定性,并忽略无关上下文
RAFT:检索增强微调(Retrieval-Augmented Fine-Tuning)
RAFT [425] 训练模型在混合了相关文档与干扰文档的情况下回答问题,教会模型识别并只使用相关上下文:
- 对每个训练样本 ,采样 篇干扰文档
- 微调输入:
[q, , , …, ][chain-of-thought + a] - 思维链明确引用 的内容,教会模型让答案有据可依
检索器—生成器联合训练
为了获得最佳性能,检索器与生成器可以联合训练。REALM [128] 和 RAG [209] 论文提出端到端训练,让梯度流经检索步骤:
检索器参数 使用 REINFORCE 估计器更新,也可以把 视为对文档的可微注意力。
各种 RAG 方法的综合对比
| 方法 | 准确率 | 延迟 | 复杂度 | 成本 | 适用场景 |
|---|---|---|---|---|---|
| 朴素 RAG [209] | 中 | 低 | 低 | 低 | 原型验证、简单问答 |
| RAG + 重排序 [268] | 高 | 中 | 中 | 中 | 生产级问答系统 |
| HyDE [106] | 高 | 中 | 低 | 中 | 语义不匹配的领域 |
| Multi-Query RAG | 高 | 中 | 中 | 中 | 歧义查询 |
| RAG-Fusion [300] | 高 | 中 | 中 | 中 | 多样的查询类型 |
| Self-RAG [13] | 高 | 中 | 高 | 中 | 选择性检索 |
| CRAG [401] | 高 | 中 | 高 | 高 | 不可靠的语料库 |
| Adaptive RAG [162] | 高 | 低–高 | 高 | 中 | 混合的查询复杂度 |
| Graph RAG [82] | 极高 | 高 | 极高 | 高 | 全局综合类查询 |
| Agentic RAG | 极高 | 高 | 极高 | 高 | 多跳推理 |
| RAFT [425] | 极高 | 低 | 极高 | 极高 | 领域专用部署 |
表 16.7:各类 RAG 方法在关键维度上的对比