
动机:为什么 Agent 需要环境
对话式语言模型的评估在原则上是直截了当的:给出一个 Prompt、收集一次回复,并依据参考答案或人工评判对其进行打分。智能体(Agent)评估则根本不同。智能体必须在世界中行动、观察后果,并在连续多步中调整自身行为。任何单次回复都无法刻画这一点;只有结构化的环境才能做到。
范围说明。我们在强化学习意义上使用环境一词:智能体为训练或评估而与之交互的世界——而非在线服务时承载智能体的生产基础设施(脚手架(harness)、编排器)。执行沙箱在此处出现,是因为它们使这类环境成为可能,但智能体脚手架本身在第 18 章讨论。
有三股力量推动了对专用智能体环境的需求:
真实世界系统——生产数据库、在线网站、金融 API——无法承受训练中的智能体所进行的探索行为。沙箱环境提供一个忠实副本,智能体可在其中失败、恢复、学习,而不会造成不可逆的损害。安全隔离(如 Docker 容器、受限网络的虚拟机)不是可选项,而是一等设计要求。
基准(Benchmarks)要求每个智能体在相同条件下面对同一任务。环境必须能按需具备确定性、受版本控制并可分发,以便一个实验室报告的结果能在另一个实验室复现。这一性质的缺失在历史上使智能体基准难以比较。
从零开始在困难任务上训练智能体在样本效率上很低。提供难度课程的环境——随着智能体的进步逐步提高任务复杂度——可显著减少达到目标性能水平所需的环境交互次数。这与人类学习的方式相似:子技能的掌握先于对整体的掌握。
环境设计原则
一个设计良好的智能体环境暴露出四个正交的设计轴:观察空间、动作空间、奖励信号和Episode 结构。让每一项都正确是必要的;让四者同时正确则是环境工程的手艺所在。
观察空间设计
观察是智能体在每一步所看到的内容。对于基于 LLM 的智能体,观察几乎总是以文本形式呈现,但其来源材料差异极大:
- 纯文本:终端输出、文件内容、API 响应、错误信息。与任意 LLM 的兼容度最高,但丢失空间和视觉结构。
- 结构化(JSON/XML):机器可读的状态表示。可实现精确的指代落地,但要求智能体解析结构而非阅读散文。
- 多模态:截图、可访问性树、渲染后的 HTML。GUI 和 Web 任务必备;需要具备视觉能力的模型或独立的感知模块。
- 混合:截图配合可访问性树(OSWorld 和 VisualWebArena 中使用),同时提供视觉上下文和结构化元素标识符,融合了两种模态的优势。
动作空间设计
动作空间定义了智能体可以做什么。对于 LLM 智能体,动作通常是一段文本字符串,由环境解析并执行。常见动作类型包括:
- 工具调用:对外部函数(搜索、计算器、日历)的结构化调用。常以 JSON 或 XML 函数调用语法格式化。
- 代码执行:智能体写出的代码在沙箱中运行;stdout/stderr 作为下一次观察返回。这是最具表达力的动作类型。
- API 交互:对 Web 服务的 HTTP 请求、数据库查询、Shell 命令。
- GUI 动作:
click(x,y)、type("text")、scroll(direction)、key("Enter")。用于计算机使用类环境。 - 自然语言:发送给另一个智能体、人类或子任务规划器的自由文本。
奖励信号设计
奖励设计是环境工程中最难的部分。奖励必须:
- 对齐:高奖励应对应真正的任务完成,而非表面代理指标。
- 可学习:信号必须足够稠密,以使智能体能够取得进展;长时程任务上的纯稀疏奖励若没有额外的塑形(shaping)通常无法学习。
- 抗作弊:智能体不应能够在未真正完成任务的情况下获得高奖励(reward hacking,奖励作弊)。
| 奖励类型 | 优点 | 缺点 |
|---|---|---|
| 稀疏(结束时 0/1) | 对齐性好,难以作弊 | 难以学习 |
| 稠密(步级) | 易于学习 | 易产生塑形伪影 |
| 内在型(好奇心) | 驱动探索 | 可能偏离任务 |
| LLM 作为评判者 | 灵活、细腻 | 昂贵、不一致 |
| 基于执行 | 真值依据 | 仅适用于可验证的任务 |
表 21.1:智能体环境中各类奖励信号及其权衡。
Episode 结构
Episode 可以采用若干结构:
- 定长:智能体恰好走 步。实现简单;在已解决的任务上浪费算力。
- 提前终止:当智能体标示完成或达到终止状态时 Episode 结束。效率更高,但需要可靠的终止检测器。
- 开放式:无固定时程;智能体持续运行直到资源预算(Token、API 调用次数、墙钟时间)耗尽。最接近真实部署,但最难评估。
近期工作挑战了「Episode 长度必须在训练开始前固定」这一假设:
- 时程课程。AELA [411] 从短 Episode 开始,并随智能体能力的提升(以策略熵的收敛来度量)逐渐扩展时程。前期的短 Episode 每个训练样本能暴露更多样化的初始状态。
- 截断作为 RL 惩罚。DLER [236] 表明,对于推理模型,最简单的长度控制——硬截断——只要配合批级别的奖励归一化和动态采样,就能很好地工作,从而避免被截断的 rollout 丢失奖励信号。
- 学习停止。模型本身可以学习何时停止推理,而非依赖固定预算。[228] 提出三种策略:当连续的推理步骤收敛到同一答案时停止、提高思考结束 token 的概率,或在隐状态激活上训练一个轻量级分类器来预测最优停止点。
- 部分 rollout 回收。APRIL [251] 超额申请 rollout 请求,并在达到目标 batch 数量后终止;未完成的回复会作为未来步骤中的热启动前缀被回收利用,从而消除少数慢样本拖住整个 batch 的长尾停滞(吞吐量提升 20–35%)。TLT [149] 针对同一瓶颈,在线训练一个自适应草稿模型来对掉队样本进行投机解码(端到端加速 1.7,无损)。
难度课程与自适应环境
静态基准衡量智能体能力的固定快照。自适应环境更进一步:它们在线监测智能体表现并调整任务难度,使智能体处于「最近发展区」——难到足以从中学习,又易到偶尔能够成功。相关技术包括:
- 程序化生成:任务从参数化分布中采样;难度参数根据近期的成功率来调整。Prioritized Level Replay [167] 依据每个生成的关卡被估计出的学习潜力(如 GAE 幅度)为其打分,并更频繁地重放高价值关卡。
- 自我博弈/对抗式环境设计:PAIRED [74] 训练一个对手来提出环境,使主角与反派智能体之间的遗憾值最大化,从而在无需人工设计难度调度的情况下自然产生复杂度递增的课程。
- 事后重标记:失败轨迹会被用智能体实际达成的目标重新标记,从而即使从失败中也能提供学习信号(Hindsight Experience Replay,HER)[8]。
- 面向 LLM 的难度定向数据选择:在 RLVR 训练中,并非所有问题都提供相同的信号。近期工作优先选择中等难度的问题——即模型大约 30–70% 的时间能够解决的问题——因为它们能产生最高的梯度信息 [370]。ADCL [231] 在模型提升的过程中周期性重新估计难度,从而避免课程过时。
Agent 环境的类型
代码执行沙箱
对 LLM 而言最基础的智能体环境是代码执行沙箱:智能体编写代码,沙箱运行代码,然后返回输出。这一简单循环支撑着真实世界中相当一部分智能体部署。
基于 Docker 的隔离是最常见的做法。每个 Episode 都从已知镜像派生一个全新容器,在其中执行智能体的代码,并在 Episode 结束时销毁该容器。网络访问、文件系统写入和进程派生都可以在容器层面控制。1
E2B(Environments to Benchmarks)2 提供托管的云沙箱 API:智能体通过 HTTP 发送代码,E2B 在一个隔离的 Firecracker microVM 中执行它(该 microVM 的启动时间不到 200 ms),并返回 stdout/stderr。E2B 处理容器生命周期管理的基础设施复杂性,使其易于集成到智能体训练循环中。
Modal3 提供类似的管理式执行模型,并具备更强的 GPU 支持,适合需要在任务中运行 ML 工作负载的智能体。
Web 环境
Web 环境为智能体提供一个浏览器,并要求它在真实或模拟网站上完成任务。
WebArena[440] 提供一个自托管的测试平台,包含四个功能完整的 Web 应用——一个电商商店、一个社交论坛、一个 GitLab 实例和一个 CMS——外加一个地图服务,总共有 812 个长时程任务。智能体通过浏览器自动化 API 交互;任务需要多步导航、表单填写和信息检索。人类表现约为 78%;最先进的 LLM 智能体达到约 35–45%。
VisualWebArena[188] 在 WebArena 基础上扩展出需要解读网页图像的视觉落地任务。观察是截图配合可访问性树;智能体必须将动作落地到两种模态上。
Mind2Web[73] 是一个大规模数据集,包含横跨 137 个真实网站的 2,000 个任务,通过人类演示收集。与 WebArena 不同,Mind2Web 关注对未见网站的泛化,因此是更难的分布外测试。
计算机使用环境
计算机使用环境让智能体控制整个桌面操作系统,并通过截图和/或可访问性 API 进行观察。
OSWorld[397] 测试跨三种操作系统(Ubuntu、Windows、macOS)的桌面自动化,包含横跨各类生产力应用(LibreOffice、VS Code、Chrome、GIMP 等)的 369 个任务。智能体观察截图,并通过 pyautogui 风格的鼠标和键盘命令执行动作。人类与智能体之间的差距十分悬殊:标注员约能完成 72% 的任务,而最强的 LLM 智能体只能做到 18%,凸显了像素级 GUI 控制的难度。
WindowsAgentArena[27] 专门针对 Windows 11,包含横跨 19 个应用的 154 个任务。它强调企业工作流:Excel 公式、PowerPoint 编辑、Outlook 电子邮件管理。
软件工程环境
软件工程(SWE)环境要求智能体解决真实世界的编程任务:修复 bug、实现功能、编写测试。
SWE-bench[169] 取自 12 个广泛使用的 Python 项目(其中包括 Django、Flask、scikit-learn)中的 2,294 个真实 pull request。每个实例将一个 issue 描述与一套留出的测试套件配对,该测试套件只有在应用正确补丁后才会通过。智能体必须理解仓库结构、定位相关代码、实现修复,并用测试套件验证。SWE-bench Verified 子集(500 个 issue)已针对正确性经过人工验证,是标准的评估目标。
SWE-agent[404] 既是基准环境,也是智能体框架。它引入了智能体-计算机接口(Agent-Computer Interface,ACI):一组为 LLM 智能体优化的 shell 命令(例如 search_file、open、edit),相比原始 bash 降低了动作空间的复杂度。
科研环境
科学研究环境推动智能体走向自主的知识生成:阅读论文、形成假设、设计实验并解读结果。
PaperQA2[198] 是一个检索增强型智能体,通过检索 PDF 语料、抽取相关段落并综合出带引用的答案来回答科学问题。它既是工具,也是文献落地推理的基准。
AI Scientist[241] 是一个端到端的研究自动化系统:给定一个研究方向,智能体会生成假设、编写并运行实验、解读结果,并产出一篇论文草稿(draft)。环境包含 Python 执行沙箱、文献检索 API 和 LaTeX 编译器。
MLAgentBench[151] 在机器学习工程任务上评估智能体:在给定的算力预算内提升模型在给定数据集上的准确率。智能体可以读取数据、编写训练脚本、运行实验并迭代。
游戏与仿真环境
游戏提供了丰富、长时程的环境,具有定义良好的奖励信号,且没有真实世界的后果。
NetHack[194] 是一款程序化生成的 roguelike 游戏,状态空间极其庞大,需要长期规划、物品栏管理以及对意外事件的适应。NetHack Learning Environment(NLE)提供与 Gym 兼容的接口。
Voyager / Minecraft[362] 使用 Minecraft 游戏引擎作为开放式环境。Voyager 引入了一个难度逐步递增的任务课程(收集木材 制作工具 建造庇护所 探索下界),以及一个跨 Episode 累积可复用代码片段的技能库。
GAIA[254] 提出 466 个需要链式工具使用的问题——网络搜索、代码执行、文件解析——并按所涉及的推理步数分为三个难度等级。该基准鲜明地暴露了人类能力(92% 准确率)与当前 LLM 智能体之间的差距(带插件的 GPT-4 在发布时得分为 15%;后来的系统达到 30%)。
多 Agent 环境
多智能体环境涉及两个或更多 LLM 智能体彼此交互,以及/或者与共享世界交互。
- 协商:拥有私有效用函数的智能体必须通过对话达成交易。经典环境包括 DealOrNoDeal [208] 和 CaSiNo [42]。
- 辩论:两个智能体就对立立场进行论证;由评判者智能体(或人类)评估论证的质量。用于通过对抗压力引出真实的推理。
- 协作式任务完成:具有互补能力的智能体(规划者、执行者、评论家(critic))必须协同完成任何单个智能体都无法独立解决的任务。相关框架包括 AutoGen [385]、CrewAI [261] 和 MetaGPT [142]。
- 竞技类游戏:智能体进行零和博弈(国际象棋、围棋、扑克),其对手本身就是 LLM 智能体。这些环境中的自我博弈已在狭窄领域产生了超越人类的表现。
OpenEnv:标准化的 Agent 环境接口
智能体环境的激增带来了一个碎片化问题:每个环境暴露不同的 API、使用不同的观察格式,并要求不同的脚手架。OpenEnv[88] 是 Hugging Face 近期推出的开源框架,直接针对这一问题:它为智能体执行环境提供 Gymnasium 风格的 [355] 接口(step()、reset()、state()),并采用隔离的、基于 Docker 的部署,通过 WebSocket 通信。OpenEnv 与更广泛的标准化努力互补,例如 AgentGym [390] 为 LLM 智能体在多样化环境中提供统一格式的平台,BrowserGym [202] 则为 web 智能体基准标准化观察空间和动作空间。下面的设计原则总结了来自这些项目、正在收敛的最佳实践。
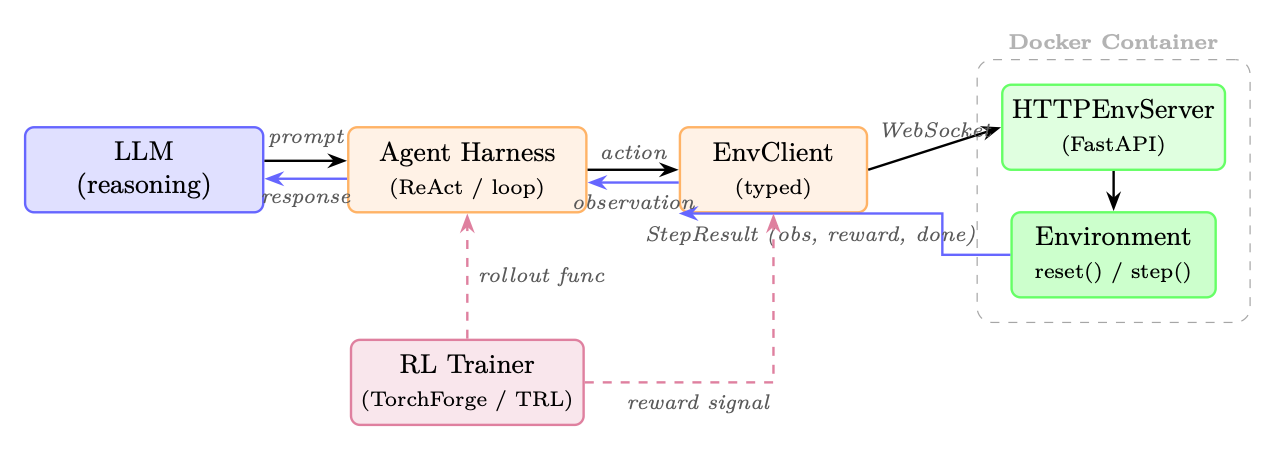
EnvClient。客户端通过 WebSocket 与运行在 Docker 容器内的 HTTPEnvServer 通信。RL 训练器(虚线)可选地包裹该循环,以收集 rollout 和奖励信号用于策略优化。标准化的 Agent–环境接口
OpenEnv 为智能体执行环境定义了带类型的接口。其设计沿袭 Gymnasium 的简洁性,但面向通过 HTTP/WebSocket 与工具交互的 LLM 智能体:
env.reset()StepResult:开始一个新的 Episode;返回初始观察。env.step(action)StepResult(observation, reward, done):执行一个动作,并返回由此产生的观察、标量奖励和终止标志。env.state()当前环境状态(Episode ID、步数、环境相关字段)。env.close():释放资源(停止容器、关闭连接)。
动作和观察都是强类型的 Python dataclass,因环境而异。例如,编程环境定义 CodeAction(code=...),并返回包含 stdout、stderr 和 exit_code 的观察;游戏环境定义自己的动作/观察类型。这种按环境定制的类型化让智能体拥有结构化、可预测的接口,同时保持三个核心方法(reset、step、state)通用。
每个环境都是一个继承自 Environment 的 Python 类(实现 reset() 和 step())。它通过 HTTPEnvServer 在 Docker 容器内提供服务,后者暴露一个 FastAPI/WebSocket 端点。客户端使用 EnvClient 的、因环境而异的子类来处理序列化和连接生命周期。容器可以通过 from_docker_image() 在本地启动,也可以通过 base URL 远程连接:
from coding_env import CodeAction, CodingEnv

# Option 1: Launch a local Docker container
client = CodingEnv.from_docker_image("coding-env:latest")

# Option 2: Connect to a remote deployment
# client = CodingEnv(base_url="http://localhost:8000")

# Interact with the environment
result = client.reset()
print(result.observation.stdout)
print(result.observation.stderr)
print(result.observation.exit_code)

result = client.step(CodeAction(code="print(2 + 2)"))
print(result.observation.stdout)       # "4\n"
print(result.observation.exit_code)    # 0
print(result.reward, result.done)

# Check state
state = client.state()
print(state.episode_id, state.step_count)

client.close()
创建一个新环境只需实现 Environment 基类:
from openenv.core.env_server import Environment, create_app
from dataclasses import dataclass

@dataclass
class MyAction:
    text: str

@dataclass
class MyObservation:
    response: str
    reward: float = 0.0
    done: bool = False

class MyEnvironment(Environment):
    def reset(self) -> MyObservation:
        return MyObservation(response="Ready")

    def step(self, action: MyAction) -> MyObservation:
        return MyObservation(response=f"Echo: {action.text}",
                             reward=1.0, done=False)

app = create_app(MyEnvironment(), MyAction, MyObservation)
# Run: uvicorn module:app --host 0.0.0.0 --port 8000
RFC 0054 引入了一个面向脚手架的层次,使 RL 训练框架可以通过 MCP 风格的 tool 调用来与环境交互。一个 build_harness_rollout_func() 辅助函数会生成与 TRL 兼容的 rollout 函数,将 OpenEnv 直接接入 TorchForge [348] 等现有训练流水线。
OpenEnv 由一个技术委员会公开治理,成员包括 Meta-PyTorch、NVIDIA、Unsloth、Modal、Prime Intellect、Reflection 和 Hugging Face——从而确保该标准在广泛的产业输入下演进,而非服务于单一厂商的议程。
环境注册与发现
OpenEnv 环境可以部署为 Hugging Face Spaces 或本地 Docker 镜像,从而无需手动安装即可被发现和使用。无论部署目标是什么,同一个客户端接口都能工作:
from echo_env import EchoAction, EchoEnv

# Connect to a remote HF Space deployment
client = EchoEnv(base_url="https://openenv-echo-env.hf.space")
result = client.reset()
print(result.observation.echoed_message)  # "Echo environment ready!"

result = client.step(EchoAction(message="Hello!"))
print(result.observation.echoed_message)  # "Hello!"
print(result.reward)
client.close()
OpenEnv 生态已涵盖 70 多个环境(OpenSpiel 游戏、Atari、BrowserGym、编程沙箱、金融 RL、交通仿真等)。RFC 0025 提出了正式的工具发现协议,使智能体能够在运行时查询一个陌生环境接受哪些动作。
组合式环境
真实世界的智能体部署很少只使用单个工具。OpenEnv 支持丰富的环境,通过带类型的动作暴露多种能力。例如,一个编程环境在单个沙箱会话中支持代码执行、文件 I/O 和 shell 命令:
from coding_env import CodeAction, CodingEnv

client = CodingEnv.from_docker_image("coding-env:latest")
result = client.reset()

# Execute code
result = client.step(CodeAction(code="x = 42\nprint(x)"))
print(result.observation.stdout)   # "42"
print(result.observation.exit_code)  # 0

# State persists across steps within an episode
result = client.step(CodeAction(code="print(x + 1)"))
print(result.observation.stdout)   # "43"

state = client.state()
print(state.step_count)  # 2

client.close()
对于需要多样化工具访问(代码 + 网页 + 文件)的智能体(Agent),OpenEnv 的 RFC 0036 提出了模型上下文协议(MCP)集成方案,允许把任何兼容 MCP 的工具服务器包装为 OpenEnv 环境。此外,openenv CLI 能用一条命令完成新环境的脚手架生成、构建与部署,并发布到 Hugging Face Spaces。
环境版本控制与可复现性
基准完整性要求环境行为在评估时被冻结。最佳实践包括:
- 语义化版本(Semantic Versioning):
WebArena-v1.2.0保证在小版本内向后兼容。 - Docker 镜像固定:环境运行时被打包为一个带内容寻址哈希的 Docker 镜像。
- 基于种子的确定性:所有随机性要素(程序化生成、网络响应)都被设定种子并记录,从而使任何轨迹都能被精确重放。
- 排行榜快照:公开排行榜在记录分数的同时记录环境版本,防止基准无声漂移。
构建自定义环境
面向 LLM Agent 的 Gymnasium 风格 API
Gymnasium API [355]7(OpenAI Gym 的后继者)是 RL 环境事实上的标准。为 LLM 智能体适配它需要两处修改:(1) 观察与动作是字符串(或包含字符串的 dict),而不是数值数组;(2) step 方法必须处理异步的工具执行。
奖励函数工程
LLM 智能体环境的奖励函数通常是基于执行的:环境在每个 episode 结束后运行验证器,任务被解决则返回 1,否则返回 0。对于没有明确验证器的任务,可选方案包括:
- LLM 作为评判者(LLM-as-judge):由另一个 LLM 依据任务描述为智能体的最终状态打分。
- 基于评分量规的评分:结构化的评分量规把任务分解为若干子标准,每个子标准独立打分。
- 人工标注:由人工评估者对随机抽样的轨迹打分;这些分数用于校准自动化代理指标。
状态管理与检查点
长时程任务可能需要数小时的墙钟时间(wall time)。环境应支持:
- 状态序列化:完整的环境状态(文件系统、浏览器 cookie、数据库内容)可以被序列化到磁盘并恢复。
- Episode 中途检查点:智能体可以在任意步骤保存检查点并从中恢复,从而支持树搜索式的探索。
- 轨迹日志:每个观察、动作与奖励都被记录到结构化文件中,用于离线分析与奖励模型训练。
用于训练数据采集的并行化
通过 RL 训练 LLM 智能体需要数百万次环境交互。并行化策略包括:
- 进程级并行:启动 个相互独立的环境进程;并行采集轨迹。
- 异步 rollout worker:使用异步事件循环(例如
asyncio),让 LLM 推理延迟与环境执行相互重叠。 - 向量化环境:把多个环境合批到单次
step调用中,摊薄 Python 的开销。 - 云原生扩展:使用作业调度器(Ray、SLURM)把环境 worker 分布到集群上,并用一个中心 replay buffer 汇总轨迹。
环境–Agent 接口模式
图 图 21.2 展示了实践中使用的四种主要接口模式。
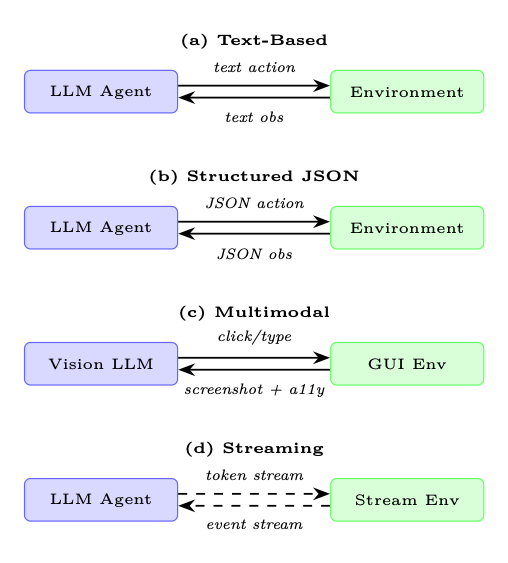
智能体接收字符串形式的观察,并产出字符串形式的动作。环境解析该动作(例如从 <tool>...</tool> 块中提取一次工具调用),并把结果作为字符串返回。这是兼容性最好的模式:任何 LLM 都能参与,无需特殊架构。
观察与动作是带有已定义 schema 的 JSON 对象。这带来了严格校验(在执行前拒绝格式非法的动作)、结构化日志,以及更易做的轨迹程序化分析。代价是智能体必须可靠地产出合法 JSON,而这要么需要微调,要么需要受约束解码。
用于计算机操作与网页环境。观察是一个元组 (screenshot: PIL.Image, a11y_tree: dict)。截图提供视觉上下文;可访问性树提供元素标识符,可在动作中使用而无需指定像素级坐标。这种混合方式比纯粹基于截图的控制更稳健。
当前大多数环境采用回合制模型:智能体产出一个完整动作,环境执行该动作,然后返回下一个观察。流式环境允许智能体在观察到达时接收部分观察(例如某条长时运行命令的输出),并在流中途打断或改变执行方向。这更接近人类与计算机交互的方式,但需要更复杂的智能体架构。
评估 harness 设计
评估脚手架(harness)是在一套基准上运行智能体、采集结果并产出汇总统计的基础设施。优秀的脚手架设计与优秀的环境设计同等重要。
确定性 vs. 随机性环境
- 确定性环境对相同的动作序列产生相同的观察序列。它们易于调试和复现,但可能无法反映真实世界的变异性。
- 随机性环境引入随机性(程序化生成、网络延迟、用户模拟)。它们需要对每个任务做多次运行,以估计平均性能与置信区间。
留出测试环境
基准完整性要求在 环境 层面(而不仅是任务层面)进行严格的训练/测试划分。在 WebArena 任务上训练过的智能体,应在一组训练期间未使用过的留出任务上评估。理想情况下,留出集合覆盖的网站、任务类型和难度等级都与训练集不同。
跨环境泛化
对智能体的终极考验是:在一个环境中习得的技能能否迁移到另一个环境。跨环境评估协议衡量:
- 零样本迁移:在环境 A 上训练,不做任何微调地在环境 B 上测试。
- 少样本适配:在评估前提供来自环境 B 的 个示范。
- 持续学习:依次在环境 A、B、C 上训练;在 C 上训练完成后测量在这三个环境上的性能。
人类基线采集
每个基准都应把人类性能作为参照点纳入进来。人类基线有三个用途:
- 它们为任务难度建立上界。
- 它们揭示任务是否根本可解(有些基准任务被证明是含糊的或无法完成的)。
- 它们为解读智能体分数提供校准点(「该智能体达到了人类性能的 40%」)。
人类基线应从具备领域专长的工作者那里采集(例如 SWE-bench 应由软件工程师而非众包工人完成),并且应包含任务耗时测量,以便进行效率比较。
代码示例:最小的自定义 LLM Agent 环境
"""
minimal_env.py  --  A minimal file-editing environment for LLM agents.

The agent receives a Python file with a bug and a failing test.
It must edit the file until the test passes.
Reward: 1.0 if all tests pass, 0.0 otherwise.
"""

from __future__ import annotations
import subprocess, shutil, tempfile, textwrap
from pathlib import Path
from dataclasses import dataclass, field
from typing import Any

# ---------------------------------------------------------------------------
# Data structures
# ---------------------------------------------------------------------------

@dataclass
class StepResult:
    observation: str          # Text fed to the LLM
    reward: float             # 0.0 or 1.0
    terminated: bool          # Episode over (task solved or max steps)
    truncated: bool           # Episode cut short (budget exceeded)
    info: dict[str, Any] = field(default_factory=dict)

# ---------------------------------------------------------------------------
# Environment
# ---------------------------------------------------------------------------

class FileEditEnv:
    """
    A Gymnasium-style environment for LLM-based code repair.

    Observation space : str  (file contents + test output)
    Action space      : str  (one of: view, edit, run_tests, submit)
    Reward            : 1.0 on passing all tests, 0.0 otherwise
    """

    MAX_STEPS = 20          # Hard episode limit
    TIMEOUT   = 30          # Seconds per test run

    def __init__(self, buggy_code: str, test_code: str,
                 task_description: str):
        self.buggy_code       = buggy_code
        self.test_code        = test_code
        self.task_description = task_description
        self._workdir: Path | None = None
        self._step_count = 0

    # ------------------------------------------------------------------
    # Core API
    # ------------------------------------------------------------------

    def reset(self, seed: int | None = None) -> tuple[str, dict]:
        """Initialise a fresh episode; return (observation, info)."""
        if self._workdir and self._workdir.exists():
            shutil.rmtree(self._workdir)

        self._workdir    = Path(tempfile.mkdtemp(prefix="fileenv_"))
        self._step_count = 0

        # Write initial files
        (self._workdir / "solution.py").write_text(self.buggy_code)
        (self._workdir / "test_solution.py").write_text(self.test_code)

        obs = self._build_observation(
            action_taken="[Episode start]",
            test_output=self._run_tests()
        )
        return obs, {"step": 0}

    def step(self, action: str) -> StepResult:
        """Execute one agent action; return StepResult."""
        self._step_count += 1
        action = action.strip()

        # --- Parse and dispatch action ---
        if action.startswith("view"):
            result_text = self._action_view()
        elif action.startswith("edit"):
            result_text = self._action_edit(action)
        elif action.startswith("run_tests"):
            result_text = self._run_tests()
        elif action.startswith("submit"):
            result_text = self._run_tests()
        else:
            result_text = (
                f"Unknown action: {action!r}\n"
                "Valid actions: view | edit <new_content> | "
                "run_tests | submit"
            )

        test_output = self._run_tests()
        passed      = "passed" in test_output and "failed" not in test_output
        reward      = 1.0 if passed else 0.0
        terminated  = passed or action.startswith("submit")
        truncated   = self._step_count >= self.MAX_STEPS

        obs = self._build_observation(action, test_output)
        return StepResult(obs, reward, terminated, truncated,
                          {"step": self._step_count,
                           "passed": passed})

    def render(self) -> str:
        """Return a human-readable summary of the current state."""
        if self._workdir is None:
            return "[Environment not initialised]"
        code = (self._workdir / "solution.py").read_text()
        return f"=== solution.py ===\n{code}\n"

    def close(self) -> None:
        """Release resources."""
        if self._workdir and self._workdir.exists():
            shutil.rmtree(self._workdir)
            self._workdir = None

    # ------------------------------------------------------------------
    # Private helpers
    # ------------------------------------------------------------------

    def _action_view(self) -> str:
        code = (self._workdir / "solution.py").read_text()
        return f"Current solution.py:\n```python\n{code}\n```"

    def _action_edit(self, action: str) -> str:
        # Expect: edit\n```python\n<code>\n```
        try:
            new_code = action.split("```python")[1].split("```")[0]
            (self._workdir / "solution.py").write_text(new_code)
            return "File updated successfully."
        except IndexError:
            return "Edit failed: wrap new code in ```python ... ```"

    def _run_tests(self) -> str:
        result = subprocess.run(
            ["python", "-m", "pytest", "test_solution.py",
             "-v", "--tb=short", "--no-header"],
            cwd=self._workdir,
            capture_output=True, text=True,
            timeout=self.TIMEOUT
        )
        return result.stdout + result.stderr

    def _build_observation(self, action_taken: str,
                           test_output: str) -> str:
        code = (self._workdir / "solution.py").read_text()
        return textwrap.dedent(f"""
            TASK: {self.task_description}
            STEP: {self._step_count}/{self.MAX_STEPS}

            --- Last action ---
            {action_taken}

            --- Current solution.py ---
            {code}

            --- Test output ---
            {test_output}

            --- Available actions ---
            view                          # show current file
            edit\n```python\n<code>\n```  # replace file contents
            run_tests                     # run pytest
            submit                        # finalise and end episode
        """).strip()

# ---------------------------------------------------------------------------
# Example usage
# ---------------------------------------------------------------------------

if __name__ == "__main__":
    BUGGY = "def add(a, b):\n    return a - b\n"   # bug: minus not plus
    TESTS = (
        "from solution import add\n"
        "def test_add(): assert add(2, 3) == 5\n"
    )

    env = FileEditEnv(BUGGY, TESTS, "Fix the add() function.")
    obs, _ = env.reset(seed=0)
    print(obs)

    # Simulate one correct edit
    fix = "edit\n```python\ndef add(a, b):\n    return a + b\n```"
    result = env.step(fix)
    print(f"\nReward: {result.reward}  |  Terminated: {result.terminated}")
    env.close()
代码清单 26:遵循 Gymnasium API 的最小 LLM 智能体环境。
主要 Agent 环境对比
表 表 21.2 汇总了本节讨论的主要智能体环境的关键属性。
| 环境 | 观察类型 | 动作空间 | 领域 | # 任务数 | 人类 | SoTA LLM |
|---|---|---|---|---|---|---|
| WebArena | 文本 + DOM | Browser API | 网页导航 | 812 | 78% | 45% |
| VisualWebArena | 截图 + DOM | Browser API | 可视化网页 | 910 | 88% | 35% |
| Mind2Web | 截图 + DOM | Browser API | 真实网站 | 2,000 | — | 30% |
| OSWorld | 截图 | 鼠标 + 键盘 | 桌面操作系统 | 369 | 72% | 18% |
| WindowsAgentArena | 截图 | 鼠标 + 键盘 | Windows 应用 | 154 | 75% | 20% |
| SWE-bench Verified | 文本(仓库) | Shell + 编辑器 | 代码修复 | 500 | 100% | 50% |
| GAIA(Level 1) | 文本 + 文件 | 工具调用 | 通用问答 | 165 | 92% | 55% |
| GAIA(Level 3) | 文本 + 文件 | 工具调用 | 高难度问答 | 42 | 92% | 10% |
| NetHack(NLE) | 文本 + 图形符号 | 离散动作 | Roguelike 游戏 | — | 10k 分数 | 5k 分数 |
| Voyager(Minecraft) | 文本 + 代码 | 代码执行 | 开放世界游戏 | 课程 | — | 15+ 科技树 |
| MLAgentBench | 文本 + 代码 | Shell + 编辑器 | 机器学习工程 | 13 | — | 40% |
表 21.2:面向 LLM 智能体的主要智能体环境对比。「SoTA」指写作时已发表的最佳 LLM 智能体结果。在有人类性能数据的地方一并列出。
小结
智能体环境是 LLM 智能体得以训练与评估的底层基础。本节的关键要点是:
- 环境不是可选项。 安全的探索、可复现的评估与课程学习都需要结构化环境。没有环境,就无法弥合聊天机器人与智能体评估之间的鸿沟。
- 四条轴线都要仔细设计。 观察空间、动作空间、奖励信号与 episode 结构各自都有失效模式,可能让整个基准失效。
- 版图丰富但碎片化。 代码 sandbox、网页环境、计算机操作环境、SWE 环境、科学环境、游戏与多智能体竞技场各自检验不同的能力。没有任何单一环境是足够的。
- 标准化很重要。 OpenEnv [88] 提供了带 Docker 隔离的 Gymnasium 风格 API,并以 Hugging Face Spaces 作为注册表——降低了构建新环境以及跨环境比较智能体的成本。
- 人类差距真实存在,并且正在缩小。 当前的 LLM 智能体在大多数基准上达到人类性能的 20–50%。进展最快的是训练数据充裕的领域(代码),最慢的是需要细粒度感知的领域(GUI 控制)。
新兴基准(2026)
UniClawBench [215] 在真实、隔离的 Docker 容器中运行 400 个双语真实任务——跨五个功能领域检验智能体,其中包括跨平台协作。它的显著特征是引入多智能体反馈回路:一个隐藏的监督者和一个模拟用户注入真实世界的摩擦(含糊的请求、变化的需求、局部失败),衡量的是 交互韧性,而不是一次性完成任务。截至 2026 年年中,它代表着评估生产级智能体最严格的基准。
Long-Horizon-Terminal-Bench [386] 覆盖 21 个领域中的 46 个复杂任务,检验智能体能否驾驭耗时数小时而非数分钟的命令行操作。它的关键创新是 基于密集奖励的评分:对每一步的中间进展打分,而不是依赖终点处的二元成功。这揭示出一个残酷现实:即使最强大的前沿模型,也无法在不偏离轨道的情况下连续执行超过 15 条终端命令——这表明长时程顺序执行仍是一个根本性未解难题。