
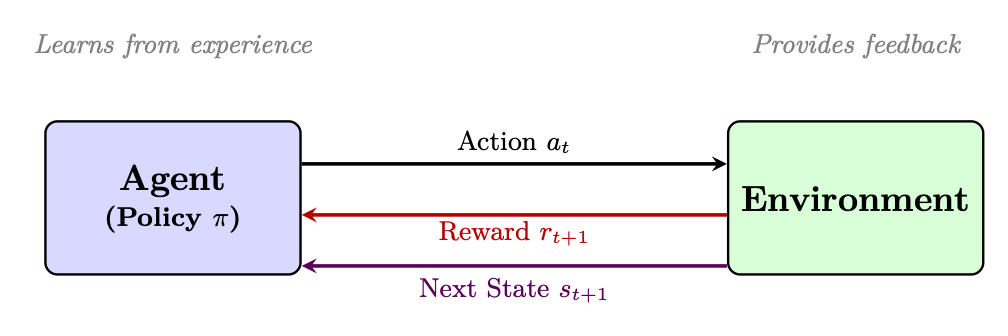
强化学习(Reinforcement Learning,RL)是一种范式:智能体(Agent)通过与环境(environment)交互、接收作为反馈的奖励(reward),并优化其策略(policy)以最大化长期累积奖励来学习做出序贯决策[346]。与监督学习(需要带标签的输入-输出对)不同,RL 通过试错来发现最优行为。
马尔可夫决策过程(Markov Decision Process,MDP)
MDP 是一个五元组:
- :状态空间——环境所有可能的配置
- :动作空间——智能体可用的所有动作
- :转移函数——在状态 下采取动作 后到达状态 的概率
- :奖励函数——一次状态转移获得的即时标量反馈
- :折扣因子——未来奖励相对于即时奖励的权重
马尔可夫性质:未来只依赖于当前状态,而不依赖于历史:
这一性质使问题变得可处理。
核心概念与定义
策略(Policy):从状态到动作概率的映射。确定性策略:。随机性策略:。
回报(Return)(累积折扣奖励):
价值函数(在策略 下从状态 出发的期望回报):
动作价值函数(从状态 出发、采取动作 、其后遵循 的期望回报):
优势函数(动作 相对于平均水平好多少):
贝尔曼方程(递归关系):
强化学习方法的分类
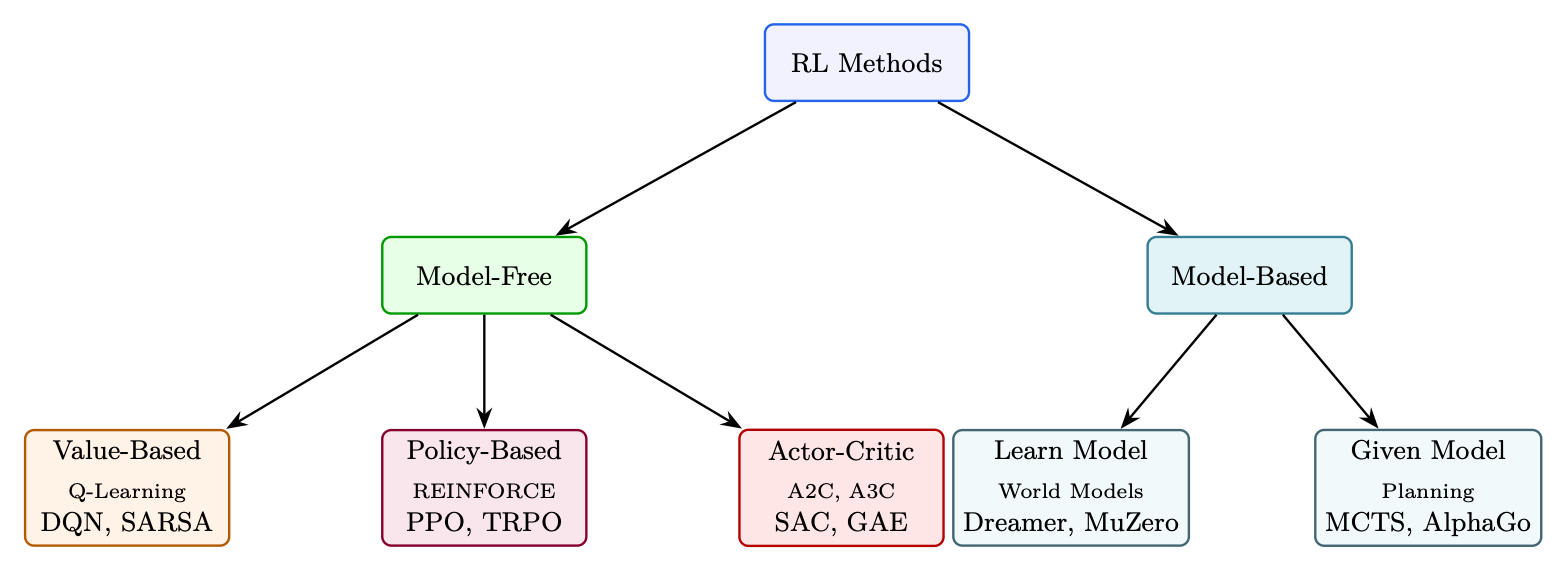
强化学习算法可以从多个维度进行分类。理解这一分类体系有助于针对特定问题选择合适的方法。
时序差分(Temporal Difference,TD)学习
TD 学习[347]采用自举(bootstrap)思想——它使用其他价值估计来更新价值估计,无需等待完整 episode 结束。
理解 TD 误差:以「惊讶」作为学习信号
TD 误差衡量智能体对未来奖励的当前估计与采取一步后新估计之间的差异。简单来说,就是智能体原本以为会发生的事,与实际发生的事加上对未来的新预期之间的差。它代表了智能体的「惊讶」。
TD 误差公式
- :采取动作后收到的即时奖励。
- :下一个状态的估计折扣价值(智能体预期从下一状态开始往后能获得的回报,按折扣因子 缩放)。
- :当前状态价值的原始估计。
合并后的项 称为 TD 目标。因此:
智能体如何使用 TD 误差
智能体调整其价值函数,使 TD 误差趋向于零:
- 如果 :结果好于预测 提高 ,使智能体趋向该状态。
- 如果 :结果差于预测 降低 ,使智能体避开该状态。
- 如果 :预测完全准确 无需更新(收敛)。
TD 目标:——我们向其逼近的「更好估计」。
多步 TD(n 步回报):
Q-Learning
Q-Learning[373] 是基础的 off-policy、基于价值算法。它直接学习最优 ,而不管当前遵循的是何种策略。
更新规则:
SARSA[311](on-policy 的替代方案):使用实际采取的动作,而非取最大值:
深度 Q 网络(DQN)[259]:用神经网络 替换表格型 。关键创新:经验回放缓冲区(off-policy 数据复用)、目标网络(稳定性)、-greedy 探索。
DQN 损失函数:网络在从回放缓冲区采样的 mini-batch 上最小化 TD 误差的均方值:
其中 是目标网络—— 的冻结副本,仅每 步更新一次(例如 )。这可以防止移动目标问题:若没有它,预测与目标会同时偏移,导致发散。
梯度更新:对 求损失的梯度(注意:目标 被视为常数——没有梯度流经 ):
学习方案(每个训练步):
- 行动:通过 -greedy 选择动作:以概率 采取随机动作,否则 。在前 100 万步内将 从 1.0 0.01 退火。
- 存储:将转移 保存到回放缓冲区 中(容量 1M)。
- 采样:从 中均匀抽取 32 条转移组成的 mini-batch。
- 计算目标:(若为终止状态,则未来价值为零)。
- 更新:对 执行梯度下降。将梯度裁剪到 (Huber 损失变体)。
- 同步目标:每 步复制 。
理解重放缓冲区
回放缓冲区[220](经验回放)是一种数据存储机制,用于保存过往经验,以便智能体日后从中重新学习。智能体不再在动作之后立即丢弃数据,而是将转移存入记忆库,并从中随机采样 mini-batch 进行训练。
存储内容:每条转移是一个元组:
其中 是表示 episode 是否结束的布尔标志。
import random
from collections import deque

class ReplayBuffer:
    def __init__(self, capacity):
        self.buffer = deque(maxlen=capacity)  # Bounded queue

    def push(self, state, action, reward, next_state, done):
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        # Break correlation by selecting random experiences
        return random.sample(self.buffer, batch_size)

    def __len__(self):
        return len(self.buffer)
策略梯度方法——REINFORCE
与其学习价值函数再导出策略,不如直接优化策略参数 ,以最大化期望回报 [379]。
目标:
策略梯度定理:
REINFORCE 算法[379](Williams,1992):
- 在 下采样完整轨迹
- 计算每个时间步的回报
- 更新:
使用基线降低方差:
任何不依赖于 的基线 都能保持梯度无偏并降低方差。最佳选择:。此时 = 优势。
Actor-Critic 方法
将策略梯度(actor)与学习得到的价值函数(critic)结合,在保持策略优化灵活性的同时降低方差。
架构:
- 演员(actor):即策略。负责提议动作。
- 评论家(critic) 或 :评估状态/动作的好坏。提供低方差的基线。
actor 更新(使用来自 critic 的优势):
critic 更新(最小化 TD 误差):
广义优势估计(Generalized Advantage Estimation,GAE)
动机:Actor-Critic 框架需要优势 的良好估计——这个动作比平均水平好多少?但这里存在一个根本性的张力:
- 1 步 TD 优势():方差低(只有一步随机性),但有偏——如果价值函数 有误,优势估计会系统性偏离。
- 蒙特卡洛优势():无偏(使用实际回报),但方差高——众多随机奖励之和在不同 episode 之间剧烈波动。
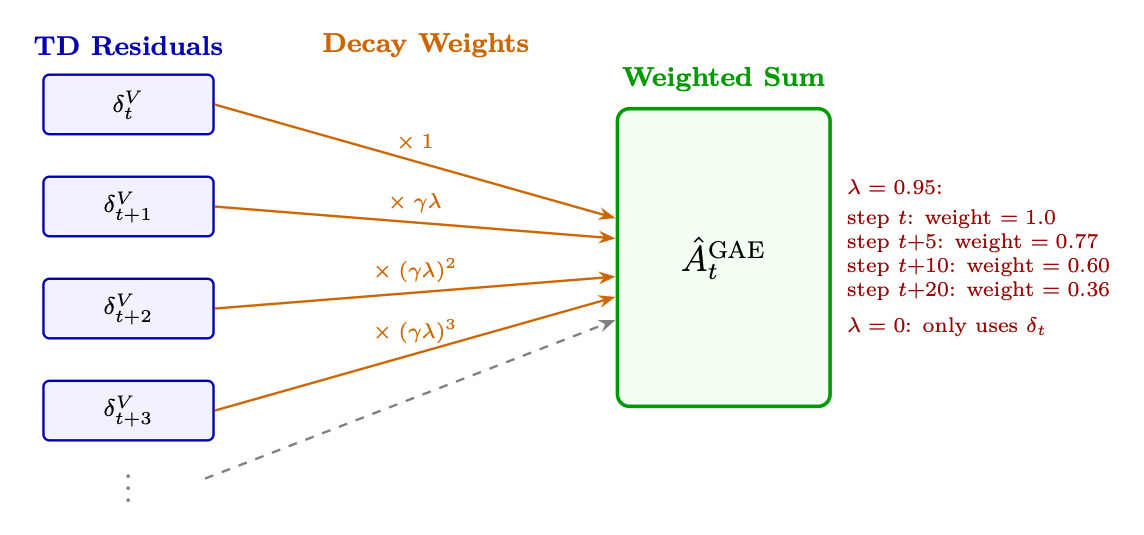
GAE[318](Schulman 等,2016)通过单个参数 在这两个极端之间提供平滑插值。它对所有 的 步优势估计取指数加权平均,给出了在偏差与方差之间权衡的原则性方法。
核心思想:在每个时间步计算 1 步 TD 误差 ,然后用指数衰减权重 将它们混合——近期的 TD 误差获得全权重,久远的则被降权:
GAE 中偏差与方差的直观映射
在监督学习中,偏差与方差源于模型的结构性假设。在通过 GAE 进行的强化学习中,它们源于你在多大程度上信任一个有缺陷的模型,相对于你在多大程度上信任一个混沌的环境:
- 偏差(系统性错位):当估计器依赖于价值网络 的结构性假设与不完美预测时产生。如果 训练不足或容量不够,基线猜测会系统性出错。
- 方差(样本抖动):当估计器依赖于长而不受约束的环境轨迹时产生。随机转移、随机种子与策略执行噪声在长时间跨度上累积,使经验样本奖励在不同 rollout 之间剧烈摆动。
架构光谱:边界情形分析
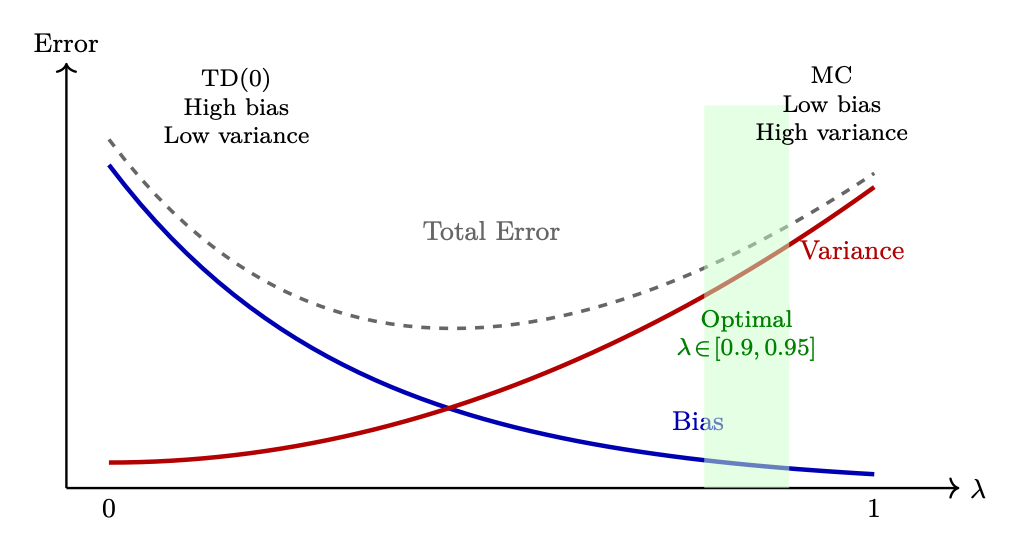
超参数 充当两种基本估计范式之间的调节标尺。
权衡矩阵
通过选择 ,GAE 最小化优势估计的总均方误差:
| 配置 | 统计特性 | 核心依赖 | 实践风险 |
|---|---|---|---|
| 高偏差、低方差 | 模型参数() | 策略陷入次优局部极小值 | |
| 平衡(最优 MSE) | 混合加权 | 需要根据环境随机性进行调参 | |
| 低偏差、高方差 | 经验环境 rollout | 破坏性梯度更新;训练爆炸 |
表 3.1:GAE 参数取值的操作层面对比。
调优 λ\lambda 的诊断方法
监控训练曲线可以直接洞察是偏差还是方差占主导:
- 高方差指标:策略熵急剧下降,同时价值函数的解释方差变得高度负向或剧烈波动 策略更新噪声很大。对策:降低 以使目标更新更平滑。
- 高偏差指标:智能体在早期训练稳定,但完全无法发现复杂的延迟奖励序列 因自举而低估了长时间跨度的依赖关系。对策:将 提高到更接近 ,使策略接触到真实的下游轨迹信号。
同策略 vs 异策略——详细对比
On-PolicyOff-Policy数据来源仅当前策略 任意策略(回放缓冲区)更新之后旧数据失效,必须重新生成旧数据仍然可用样本效率低(数据只用一次)高(数据可反复使用)稳定性更稳定(分布一致)可能发散(分布不匹配)示例REINFORCE、PPO、A2C、GRPOQ-Learning、DQN、SAC、DPO对 LLM 而言PPO、GRPO(每步都重新生成)DPO(静态偏好数据集)
基于模型 vs 无模型
无模型基于模型学习内容直接学习策略 和/或价值 /环境模型 规划无规划,反应式决策可以模拟未来轨迹样本效率低(必须亲历一切)高(可以在想象中规划)准确性无模型偏差模型误差会累积适用场景动力学复杂/未知动力学简单、需要效率示例PPO、DQN、SAC [129]MuZero [316]、Dreamer [130]、AlphaGo [331]
奖励塑形(Reward Shaping)
奖励塑形[265] 是一种技术:开发者修改或补充环境原有的奖励函数。其主要目标是把稀疏奖励场景——智能体仅在任务最终完成时才收到反馈——转化为带有中间反馈信号的密集奖励场景,以加速收敛。
数学框架
设时间步 的原始奖励为 。塑形后的奖励加上一个辅助塑形函数 :
基于势函数的奖励塑形(Potential-Based Reward Shaping,PBRS)
为了从数学上保证重塑不会改变最优策略,可采用基于势能的奖励塑形(Potential-Based Reward Shaping)。塑形函数 被约束为标量势函数 在不同状态间的差值:
其中 是实值势函数,用于评估某个状态接近目标的理想程度; 是折扣因子。
完整的 PBRS 奖励为: