
动机与历史
问题:朴素的策略梯度更新对步长没有任何约束。仅仅一次倒霉的 batch 就可能把策略推入一个生成垃圾文本的区域 垃圾文本获得低奖励 下一次梯度让情况更糟 不可挽回地崩溃。
解决方案的演进:
- TRPO[317](2015):对新旧策略之间的 KL 散度施加约束。效果完美,但需要昂贵的二阶优化(Fisher 信息矩阵、共轭梯度)。
- PPO(2017)[319]:用一个简单的一阶 clipped 目标实现类似的稳定性。实现复杂度低了 10,效果几乎一样,且能轻松扩展到分布式训练。
Clipped 目标
PPO 的核心创新是一个 clipped surrogate 目标:它能阻止破坏性的大幅策略更新,同时保持实现简单。
其中 是概率比。
完整的 PPO Loss
- 价值损失():训练评论家(critic)去预测回报。同样被 clip 以保持稳定。
- 熵奖励():防止过早收敛到确定性策略,对探索至关重要。
PPO Gradient 与更新规则的推导
本节追溯从 RL 目标到 PPO 更新规则的数学路径,说明 clipped surrogate 为何有效。
第 1 步:RL 目标
目标是在策略下最大化期望累计奖励:
第 2 步:Policy Gradient 定理
关于策略参数的梯度:
其中 是优势函数(即在状态 下动作 相对平均动作的好坏程度)。用优势替代完整回报是为了降低方差。
第 3 步:离策略数据的重要性采样
PPO 使用 收集数据,却更新 。为修正这种分布失配,需应用重要性采样:
定义概率比 。利用恒等式 ,可得:
这意味着最大化 surrogate 目标:
第 4 步:无约束 Surrogate 的问题
是一个合法的目标,但若无约束,单次梯度步就可能让 远离 1.0,导致:
- 重要性权重变得极端 方差升高
- 策略进入未经检验的区域 奖励模型给出不可靠的分数
- 灾难性崩溃:策略生成垃圾,且无法恢复
TRPO 方案:约束 。需要二阶方法(成本高)。
第 5 步:PPO 的 Clipped Surrogate(一阶近似)
PPO 用一个 clipped 目标取代硬性 KL 约束,仅使用一阶梯度即可达到类似行为:
梯度的推导:
令 ,其中 。
展开各条件:
- 当 且 :梯度正常传播——策略被鼓励提升 。
- 当 且 :梯度为 零——策略提升已足够,停止继续推。
- 当 且 :梯度正常传播——策略被鼓励降低 。
- 当 且 :梯度为 零——策略降低已足够,停止继续推。
第 6 步:完整的 PPO 更新规则
将 clipped 策略损失、价值损失与熵奖励组合起来:
其中:
Rollout Buffer 与 Rollout
在 PPO 中,数据管理依赖于一个专门的短期存储系统,称为 Rollout Buffer。与把经验无限期保存在回放缓冲区中的 off-policy 算法(DQN)不同,PPO 需要一个临时结构来满足其 on-policy 的数学约束。
什么是 Rollout?
一次 rollout(轨迹)是指智能体在环境中运行其当前策略所生成的一串交互:
- 该过程:智能体观察状态、选择动作、接收奖励,并转移到下一个状态。它会重复固定数量的步数,直至回合结束。
- 在 LLM/RLHF 中:一次 rollout 就是从一个数据集中取出一条 prompt,让语言模型逐 token 生成完整序列,直到命中文本结束标记。每个 token 就是一次「step」。
Rollout Buffer
Rollout Buffer 临时保存 rollout 阶段收集到的全部数据。对每个生成的 token / 每一步,它记录:
- :第 步的状态、所采取的动作与奖励。
- :在生成该动作的那份策略下采取该动作的对数概率(计算概率比时需要)。
- :价值函数给出的基线预测(计算 GAE 优势时需要)。
Rollout Buffer 的生命周期
该缓冲区按照严格的三阶段周期循环运转:
- 收集:当前策略与环境交互,用新鲜轨迹填满缓冲区(对于 batch=128、max_tokens=512 的 70B 模型:每次 rollout 最多 65K 条 token 级转移)。
- 训练:跨轨迹计算 GAE 优势。用 clipped 目标做 个 epoch(通常 3–10)的 mini-batch 梯度下降,以更新策略权重。
- 清空:整个缓冲区会被彻底清空。因为 PPO 是 on-policy 的,旧策略生成的数据无法安全地用于下一个更新周期——比率 会变陈旧,clipping 的保证也会失效。
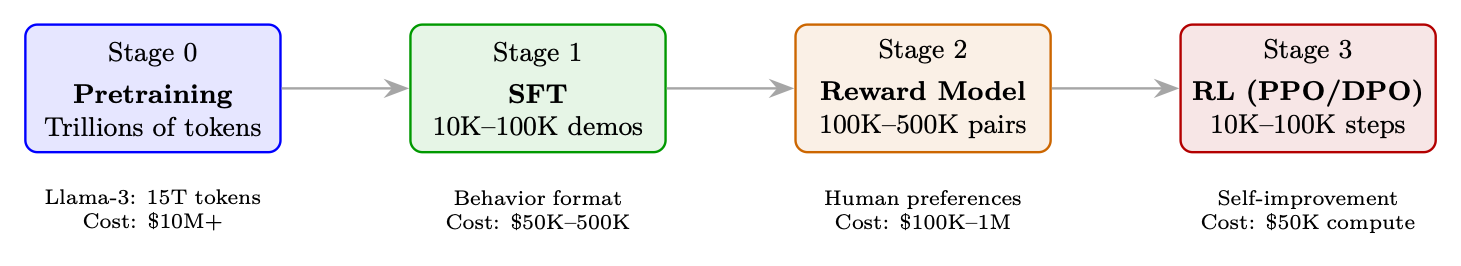
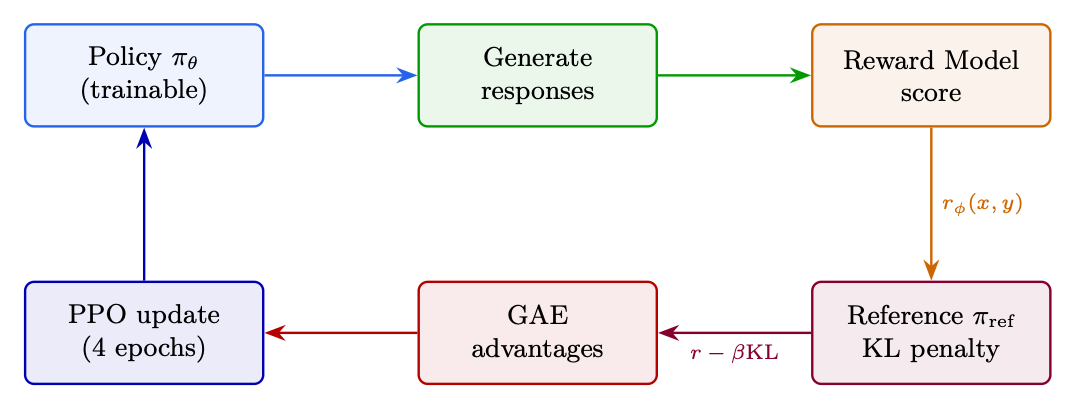
用于 RLHF 的 PPO:完整循环
细节机制:Logits 与 Policy 更新
PPO 在内存中维护两个不同的参数状态,它们共享相同的神经网络拓扑,但在优化过程中持有不同的权重值:
阶段 1:Rollout(数据收集)
在数据收集期间,智能体与环境交互 步。在每一时间步 :
- 环境给出当前状态/观测 (对 LLM 而言:prompt 加上目前已生成的 token)。
- 状态 被送入当前网络快照()。
- 网络输出原始未归一化的值——logits——一个大小为 的向量(词表规模 32K–128K)。
- 概率通过 Softmax 计算:(5.14)
- 从 中采样得到动作 (下一个 token),并把转移元组 连同 一起存入 rollout buffer。
阶段 2:优化循环(Mini-Batch 更新)
一旦 rollout buffer 填满,PPO 就会在 mini-batch 上跑 个 epoch(通常 3–10)。每次梯度步都会用存储的状态 为两个策略生成 logits:
旧策略评估(冻结):
实现捷径:直接复用 rollout 时存下的标量,而不重新计算。
在线策略评估(更新中):
由于 在每个 mini-batch 梯度步之后都会更新, 在整个优化循环中持续变化,而 始终保持完全静止。
从 Logits 到概率比
PPO 的核心比率衡量的是:同一动作在新策略下比在旧策略下更可能还是更不可能:
为避免直接相除原始概率造成灾难性的数值下溢/上溢,计算在 对数空间中进行:
对比值取差值的指数即可还原出比率:
该比率被注入 PPO 的 clipping 目标:
PPO 权重生命周期
| 阶段 | 在线 | 旧 | 比率 |
|---|---|---|---|
| 1. Rollout 开始 | 活跃副本 | 同一个活跃副本 | 始终为 (按同一性) |
| 2. Batch 第 1 步 | 计算梯度 | 冻结 | (初始步骤) |
| 3. Batch 第 步 | 修改中() | 冻结 | 偏离 (例如 、) |
| 4. Clipping 生效 | 被 约束 | 冻结 | 被困在边界() |
| 5. 优化结束 | 高度优化 | 被丢弃 | N/A |
| 6. 下一个周期 | 接收新的 | 重置回 |
表 5.1:在 PPO 训练各阶段中 与 的演化。
连续 Action 空间扩展
对于连续动作空间(对 LLM 并不典型,但对机器人 RL 很重要),网络输出的不是离散 logits,而是分布参数:
- 预测的均值向量
- 预测的标准差向量
对数概率通过高斯对数 PDF 计算:
随后比率 的计算方式完全相同,并送入同一个 clipping 目标。
TRL 实现
HuggingFace TRL 库 [376] 为 LLM 的所有主流 RL 方法提供了生产级实现。
from trl import PPOConfig, PPOTrainer, AutoModelForCausalLMWithValueHead
from transformers import AutoTokenizer
from peft import LoraConfig

# Model setup
model = AutoModelForCausalLMWithValueHead.from_pretrained(
    "meta-llama/Llama-3.1-8B-Instruct",
    torch_dtype=torch.bfloat16, device_map="auto",
    peft_config=LoraConfig(r=64, lora_alpha=16, target_modules=["q_proj","v_proj","k_proj","o_proj"])
)
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-3.1-8B-Instruct")

# PPO config with all critical hyperparameters
ppo_config = PPOConfig(
    learning_rate=1.5e-6,        # Low LR for stability
    batch_size=128,              # Prompts per step
    mini_batch_size=16,          # Gradient accumulation unit
    ppo_epochs=4,                # Epochs per batch (reuse data)
    gamma=1.0,                   # No discounting (single turn)
    lam=0.95,                    # GAE lambda
    cliprange=0.2,               # PPO epsilon
    cliprange_value=0.2,         # Value function clipping
    vf_coef=0.1,                 # Value loss coefficient
    init_kl_coef=0.05,           # Initial KL penalty
    target_kl=6.0,               # Adaptive KL target
    whiten_rewards=True,         # Normalize advantages
    gradient_accumulation_steps=4,
    max_grad_norm=1.0,
)

ppo_trainer = PPOTrainer(config=ppo_config, model=model, tokenizer=tokenizer,
    dataset=prompt_dataset, data_collator=collator)

# Training loop
for batch in ppo_trainer.dataloader:
    # 1. Generate responses
    query_tensors = batch["input_ids"]
    response_tensors = ppo_trainer.generate(
        query_tensors, max_new_tokens=512, temperature=0.7, top_p=0.9, do_sample=True
    )
    # 2. Score with reward model
    texts = [tokenizer.decode(r, skip_special_tokens=True) for r in response_tensors]
    rewards = [torch.tensor(reward_model.score(q, r)) for q, r in zip(batch["query"], texts)]
    # 3. PPO update (handles KL, GAE, clipping internally)
    stats = ppo_trainer.step(query_tensors, response_tensors, rewards)
    # Monitor: stats["ppo/mean_scores"], stats["ppo/policy/approx_kl"]
关键超参
参数典型取值设置错误的后果cliprange0.2过低:不学习。过高:不稳定。init_kl_coef0.01–0.1过低:奖励作弊。过高:卡在 SFT 阶段。target_kl4–8自适应控制器的目标值。越低越保守。ppo_epochs4过多:过拟合到 batch。过少:浪费生成算力。learning_rate过高:灾难性遗忘。batch_size64–256越大:梯度越平滑,生成算力消耗越多。temperature0.7–1.0越低:探索更少。越高:优势噪声更大。