
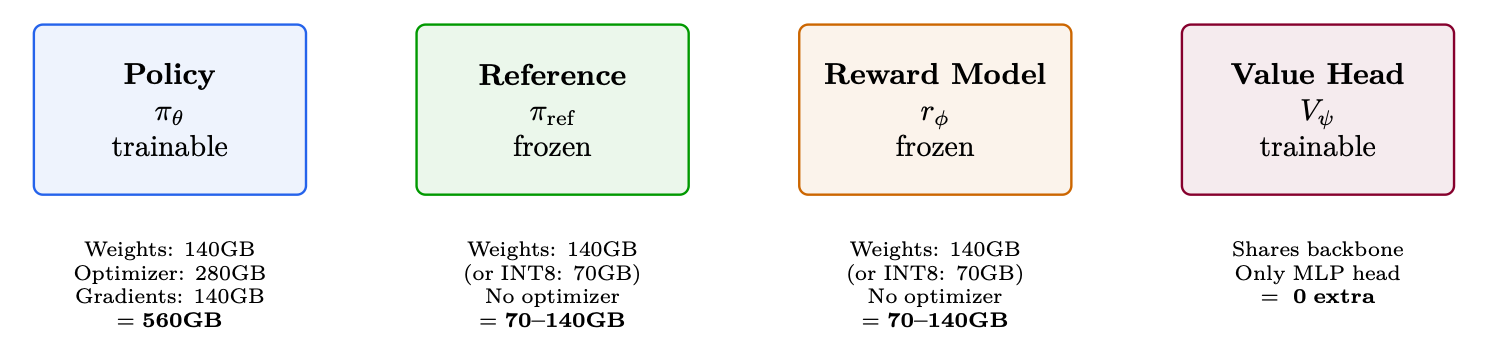
用基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)训练 LLM,既是一道算法题,也是一道系统工程题。与标准的监督微调不同——后者只涉及单一模型、单次前向-反向传播,且扩展规律已被充分理解——RLHF 需要同时加载 多个模型(policy、reference、reward model、value head),通过复杂的 rollout-打分-训练循环加以协调,并分布到数十乃至数百块 GPU 上。本章覆盖让大规模 RLHF 训练成为可能的系统级细节:显存预算、并行策略(Data、Tensor、Pipeline、Sequence 及其组合)、生成瓶颈、解耦式架构、权重同步、容错以及生产监控。
模型显存挑战
并行策略详解
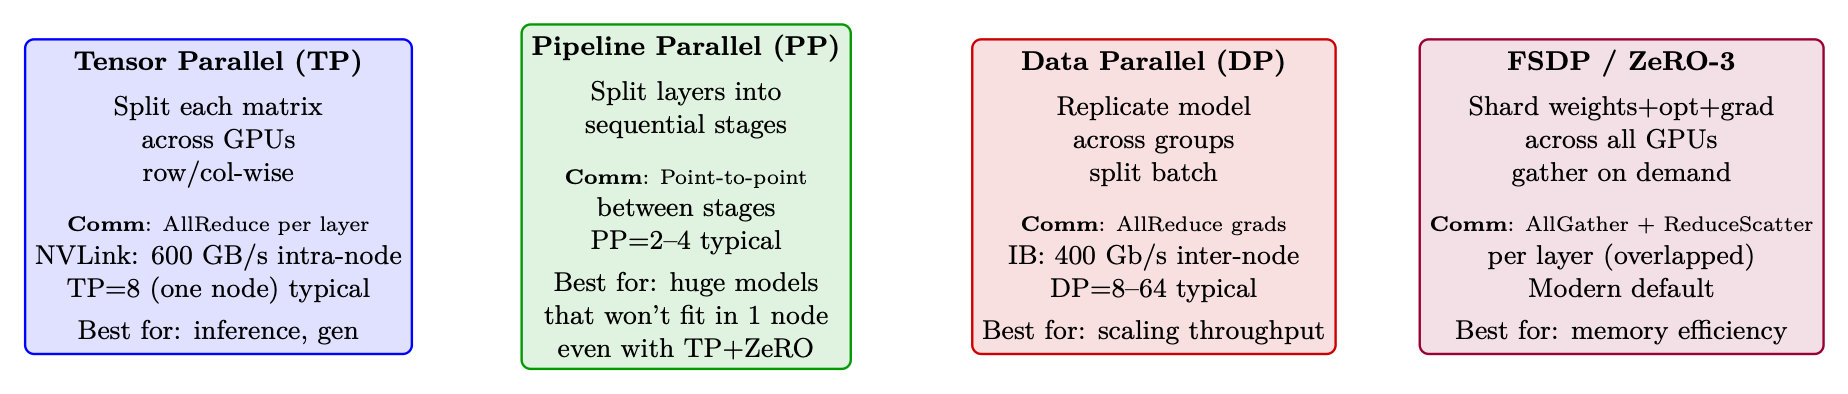
训练大语言模型必须把计算分布到许多 GPU 上。可以沿多个本质不同的维度进行并行,每种都有各自的取舍。本节用数学公式、示意图和实践指引详细介绍每种策略。
数据并行(Data Parallelism, DP)与分布式数据并行(Distributed Data Parallelism, DDP)
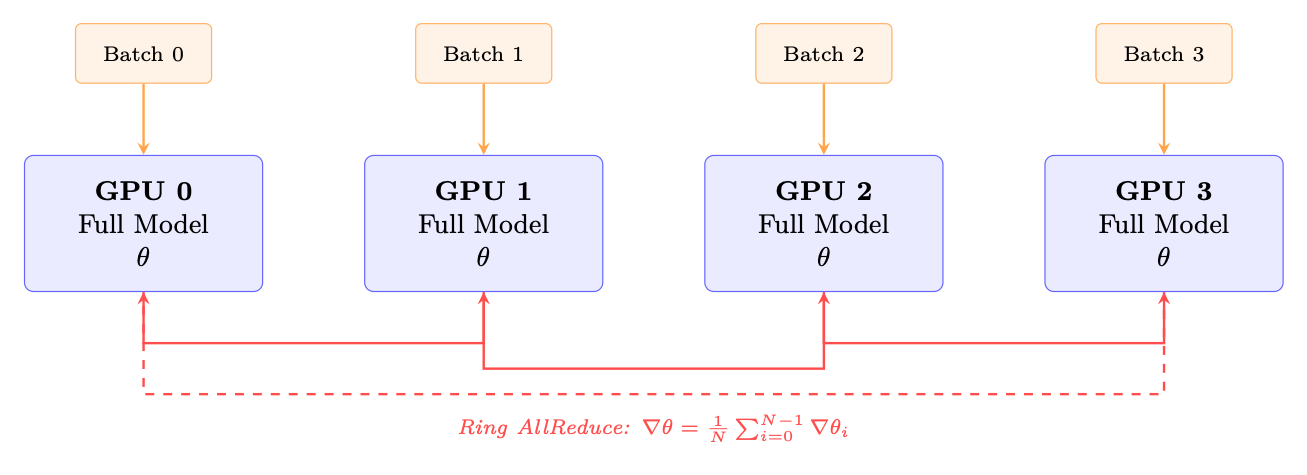
数据并行(Data Parallelism, DP)是最简单、也最常见的分布式训练形式 [210]。每块 GPU 持有模型的完整副本,处理不同的 mini-batch,并同步梯度。
单进程方案:一块“主”GPU 负责分发输入、汇集输出并广播梯度。受 GIL 以及到主 GPU 的 PCIe 带宽限制。
多进程方案:每块 GPU 各自运行一个进程。梯度在后台通过 ring-AllReduce [321] 同步,同时反向计算继续进行。
DDP 的关键特性:
- 显存:每块 GPU 都要存储完整的模型 + 优化器 + 梯度。对于 70B BF16:560 GB/GPU——如不做显存优化根本无法承受。
- 通信:每步对梯度张量做一次 AllReduce。大小 = 模型参数量 2 字节(BF16)。Ring AllReduce 开销:每 GPU 传输 字节。
- 扩展性:在 64 块 GPU 以内接近线性。超过之后通信开始占主导。
- 梯度分桶:DDP 把参数按桶分组(默认 25 MB),只要某个桶的梯度就绪就启动 AllReduce——让通信与反向计算重叠。
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP

dist.init_process_group(backend="nccl")  # NCCL for GPU communication
model = model.to(local_rank)
model = DDP(model, device_ids=[local_rank],
            gradient_as_bucket_view=True,    # Memory optimization
            static_graph=True)               # Enable comm optimizations
张量并行(Tensor Parallelism, TP)
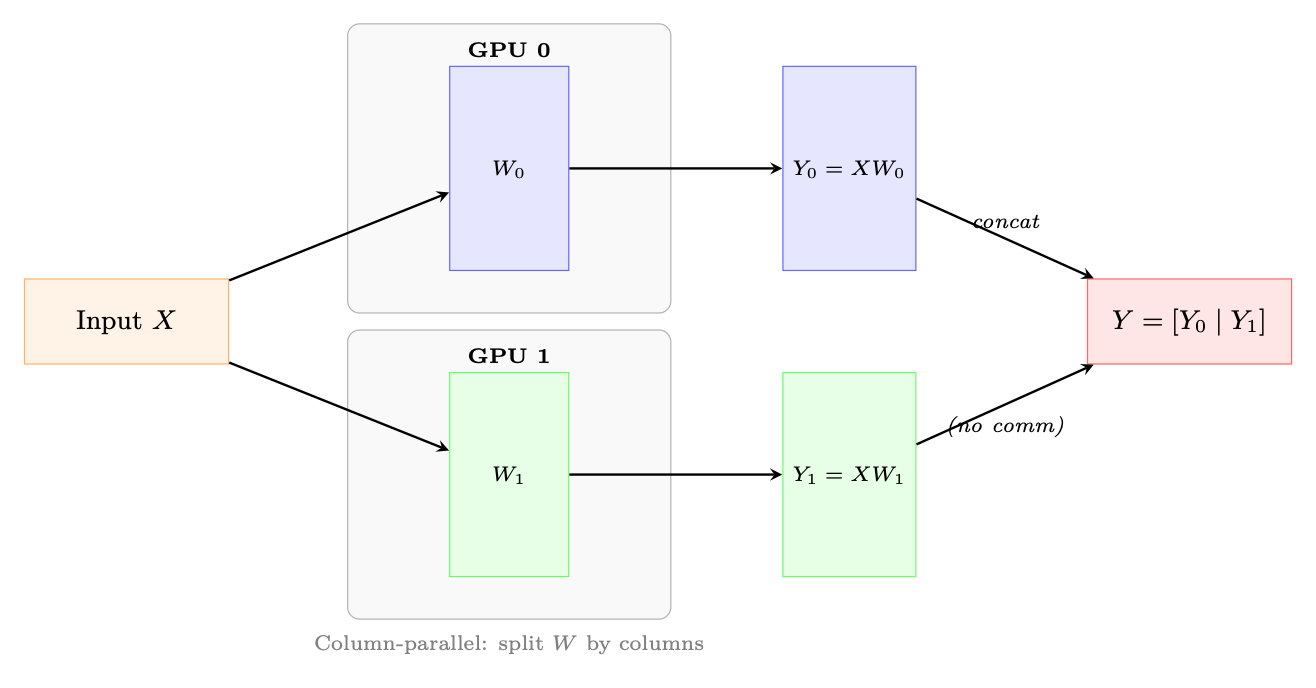
张量并行(Tensor Parallelism, TP)沿用 Megatron-LM 风格 [327],把单个权重矩阵切分到多块 GPU 上。每块 GPU 计算部分结果,再通过 AllReduce 合并。
权重矩阵 按列切分到 块 GPU 上:
每块 GPU 独立计算 (无需通信)。输出沿 hidden 维度被切开。
权重矩阵按行切分:,其中 。输入 也必须切分。每块 GPU 计算一个部分和,再通过 AllReduce 得到最终输出。
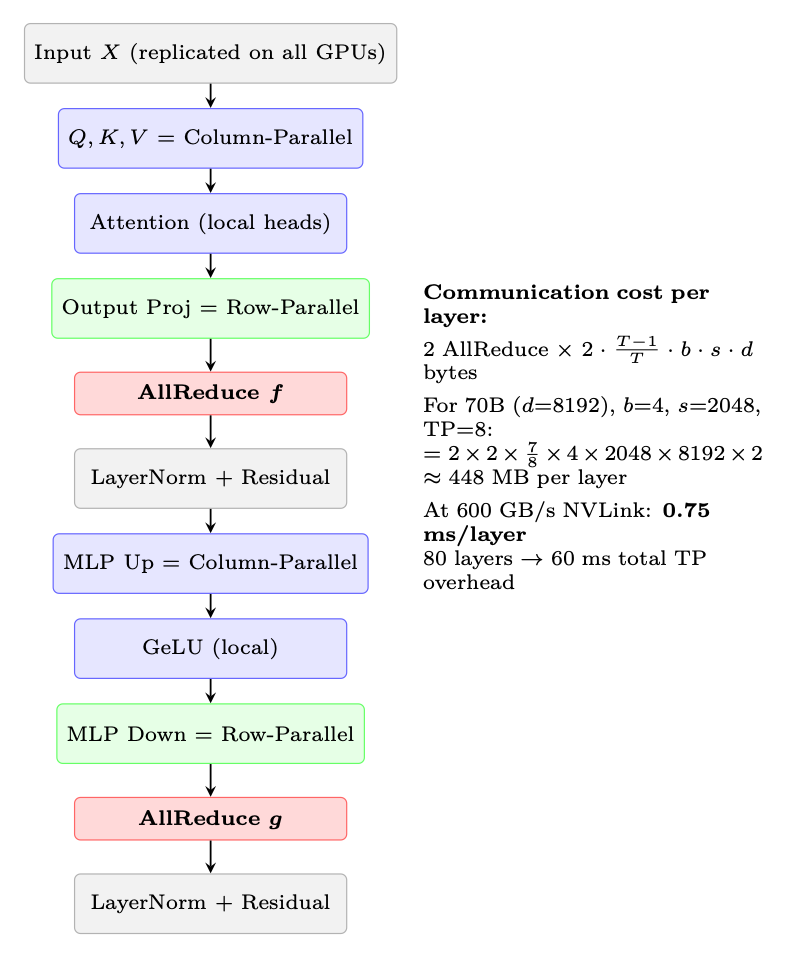
在 Transformer 层中,Megatron-LM 按以下方式应用 TP:
- MLP:第一层线性()列并行,第二层线性()行并行。行并行层之后做一次 AllReduce。
- Attention:、、 投影做列并行(按 head 切到多块 GPU)。输出投影做行并行。输出投影之后做一次 AllReduce。
- 合计:每个 Transformer 层 2 次 AllReduce(attention 一次,MLP 一次)。
序列并行(Sequence Parallelism, SP)
序列并行(Sequence Parallelism, SP)[191] 解决了单靠张量并行无法处理的显存瓶颈:LayerNorm 与 Dropout 层中的激活显存。
在 TP 下,权重显存被切分到多块 GPU 上。但 LayerNorm 与 Dropout 作用于完整的 hidden 维度,并在每块 GPU 上复制。它们的激活值(反向传播需要)占用的显存与 成正比——在每块 GPU 上都相同,不会因 TP 而减少。
对不需要跨 GPU 通信的操作(LayerNorm、Dropout、残差连接)按序列维度切分。对这些操作,每块 GPU 处理 的序列切片,然后只在需要时(attention、线性层)才汇集完整序列。
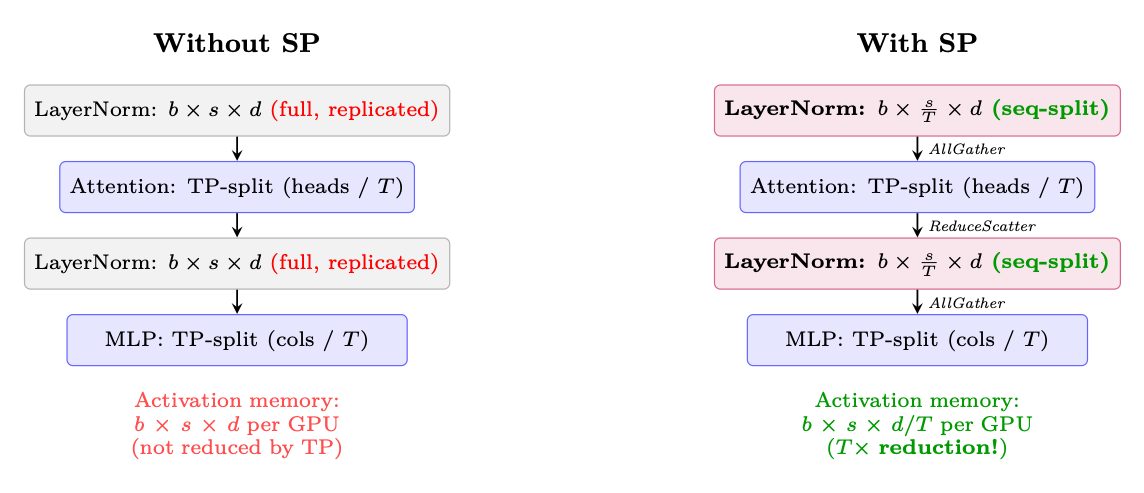
SP 带来的显存节省(70B 模型,TP=8,batch=4,seq=2048):
流水线并行(Pipeline Parallelism, PP)
流水线并行(Pipeline Parallelism, PP)按层把模型纵向切开,把连续的若干层分配给不同的设备(stage)。激活值沿 stage 向前流动,梯度向后流动。
朴素的流水线执行会产生“气泡”——某个 stage 在等待上一 stage 的输入或下一 stage 的梯度时处于空闲:
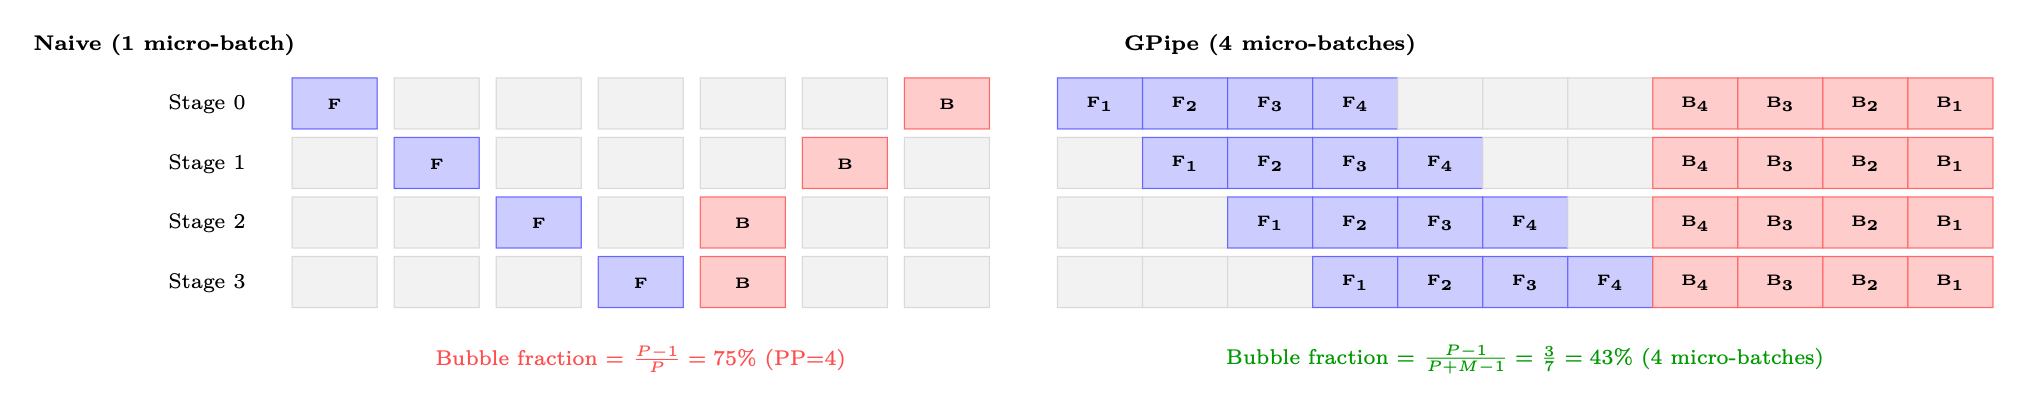
对于 个流水线 stage 和每步 个 micro-batch:
要让气泡开销 10%,需要 。对于 PP=4:至少 30 个 micro-batch。
| 调度方案 | 气泡 | 显存 | 特点 |
|---|---|---|---|
| GPipe | 个激活值 | 简单;先全部前向再全部反向 [152] | |
| 1F1B | 个激活值 | 交错执行;稳态显存有界 [263] | |
| 交错式 1F1B | 个激活值 | 虚拟 stage();进一步减少气泡 [264] | |
| 零气泡(Zero-Bubble, ZB-H1) | 个激活值 | 把反向拆分为 B 和 W 两个阶段 [296] |
表 11.1:流水线调度策略
与 TP(AllReduce)不同,PP 只需要相邻 stage 之间点对点地通信激活值:
对于 micro-batch=4、seq=2048、=8192:每次传输 MB。在 InfiniBand 50 GB/s 下:每次传输 2.6 ms——相对于每个 stage 的计算量而言很小。
并非所有层的计算量都相同:
- 嵌入(Embedding)层:非常廉价(查表)。
- Transformer Block:计算量均匀。
- 最后的 LM head:中等(词表投影需要大型矩阵乘法)。
为中间的 stage 分配更多 Transformer 层,为首尾 stage 分配更少,以平衡计算量。
完全分片数据并行(Fully Sharded Data Parallelism, FSDP / ZeRO-3)
完全分片数据并行(Fully Sharded Data Parallelism, FSDP)[431](PyTorch)与 ZeRO-3 [304](DeepSpeed)解决了 DDP 固有的显存重复问题:不再让每块 GPU 都持有参数、梯度和优化器状态的完整副本,而是每块 GPU 只持有 的切片,并在需要时按需重建完整张量。
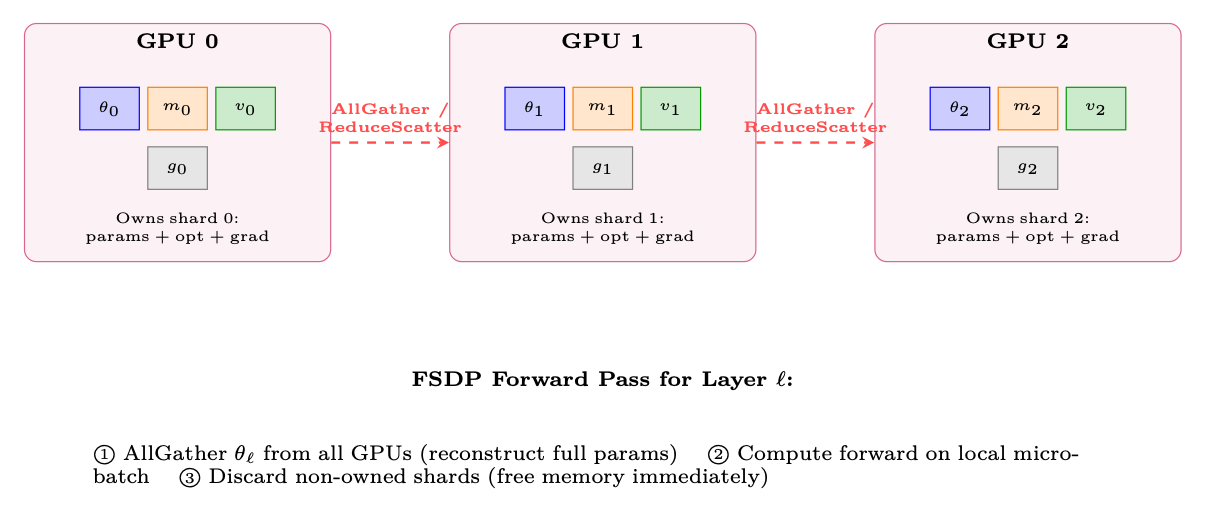
FSDP 每层的执行流程:
- 前向:AllGather 参数 计算 丢弃非本 GPU 拥有的分片。
- 反向:(再次)AllGather 参数 计算梯度 ReduceScatter 梯度(每块 GPU 得到自己的梯度分片) 丢弃非本 GPU 拥有的参数分片。
- 优化器步:每块 GPU 只用自己的梯度分片和优化器状态更新自己拥有的分片。
| 策略 | 分片对象 | 每 GPU 显存 | 通信 |
|---|---|---|---|
| DDP(不分片) | 无 | 1120 GB | AllReduce(仅梯度) |
| ZeRO-1 | 优化器状态 | 385 GB | AllReduce(梯度) |
| ZeRO-2 | 优化器 + 梯度 | 368 GB | AllReduce(梯度) |
| ZeRO-3 / FSDP | 全部 | 140 GB ✓ | AllGather + ReduceScatter(每层) |
表 11.2:显存对比:DDP 与 FSDP/ZeRO 各阶段(70B 模型,8 块 GPU)。基线:BF16 参数(140 GB)+ BF16 梯度(140 GB)+ FP32 主权重 + m + v(840 GB)= 每块 GPU 1120 GB。
from functools import partial
from torch.distributed.fsdp import FullyShardedDataParallel as FSDP
from torch.distributed.fsdp import ShardingStrategy, MixedPrecision, BackwardPrefetch
from torch.distributed.fsdp.wrap import transformer_auto_wrap_policy
from transformers.models.llama.modeling_llama import LlamaDecoderLayer

# Wrap model with FSDP
auto_wrap = partial(transformer_auto_wrap_policy,
                    transformer_layer_cls={LlamaDecoderLayer})
mp_policy = MixedPrecision(
    param_dtype=torch.bfloat16,
    reduce_dtype=torch.bfloat16,
    buffer_dtype=torch.bfloat16,
)

model = FSDP(
    model,
    sharding_strategy=ShardingStrategy.FULL_SHARD,  # ZeRO-3
    mixed_precision=mp_policy,
    auto_wrap_policy=auto_wrap,  # Wrap each transformer layer
    use_orig_params=True,        # Required for torch.compile compatibility
    limit_all_gathers=True,      # Bound peak memory (1 AllGather in flight at a time)
    forward_prefetch=True,       # Prefetch next layer's params during current layer
    backward_prefetch=BackwardPrefetch.BACKWARD_PRE,  # Prefetch during backward
)
3D 并行:组合多种策略
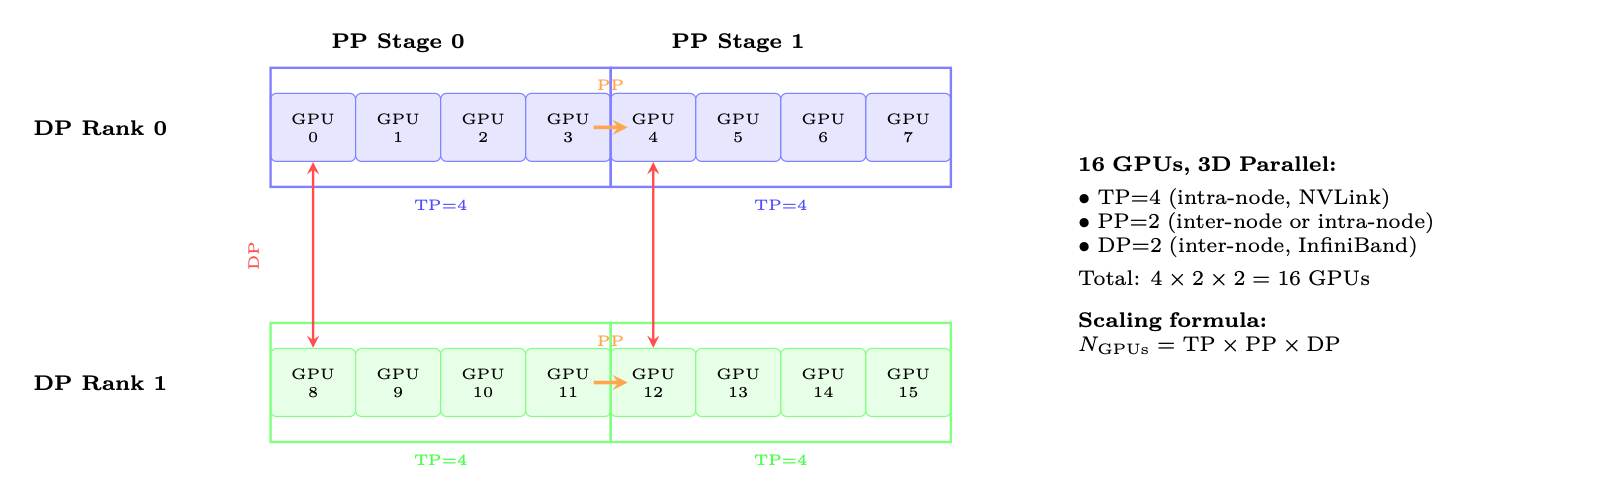
规模化生产系统(70B+)会同时组合 TP、PP 和 DP/FSDP:
| 策略 | 切分对象 | 通信 | 扩展上限 | 开销 | 适用场景 |
|---|---|---|---|---|---|
| DP/DDP | Batch | AllReduce(梯度) | 64 块 GPU | 5–10% | 模型能放进 1 块 GPU |
| FSDP | 参数+优化器+梯度 | AllGather+RS | 数百块 GPU | 10–20% | 13B 的默认选择 |
| TP | 权重矩阵 | AllReduce(每层 2 次) | 8 块 GPU(1 个节点) | 12–18% | 大模型推理+训练 |
| SP | 激活值(序列) | 复用 TP 的通信 | 与 TP 相同 | 额外 0% | 总是与 TP 一起使用 |
| PP | 层(stage) | 点对点 | 16 个 stage | 15–30% | 仅限 100B+ 模型 |
表 11.3:并行策略对比汇总
解耦 DiLoCo:跨数据中心训练
传统分布式训练假定存在高带宽互连——单一数据中心内 100+ Gbps 的 InfiniBand。这一要求使得用标准互联网链路跨地理分布的数据中心进行训练变得不可能。Decoupled DiLoCo[113](Google DeepMind,2026 年 4 月)打破了这一假设,使利用商用带宽进行跨区域大规模训练成为可能。
Decoupled DiLoCo 在此基础上进一步解耦外层同步:工作节点不必同时同步。跨区域的更新改为异步进行,由协调者在更新到达时施加外层更新。这样就能容忍广域网时延的波动。
生成瓶颈:定量分析
| 配置 | Batch | 每 batch 耗时 | Tok/s/GPU | 说明 |
|---|---|---|---|---|
| TP=1, batch=1 | 1 | 36s | 14 | 基线,最差情况 |
| TP=4, batch=1 | 1 | 9s | 57 | 生成本身的线性 TP 扩展 |
| TP=4, batch=32 | 32 | 15s | 1092 | 接近最优的批处理 |
| TP=4, batch=128, vLLM | 128 | 45s | 1456 | 连续批处理 |
| TP=4, batch=128, INT8 | 128 | 25s | 2621 | 带宽节省 2 |
表 11.4:70B 模型的生成吞吐(512 个 token,各种配置)
优化组合(累计加速比):
- vLLM + PagedAttention[196](2–4):消除键值缓存的碎片,支持更大的 batch
- 连续批处理[412](1.5–2):不必等待最长的序列,别的序列一完成就启动新序列
- 投机解码[206](2–3):小的草稿模型先提出 5 个 token,大模型用一次前向传播进行验证。平均接受 3–4 个。
- 生成使用 INT8/FP8 权重(2):带宽需求减半。由于是在采样(而非为训练计算精确 logits),质量损失很小
- CUDA graph(1.1–1.3):消除固定形状操作的 kernel 启动开销
- 前缀缓存(共享前缀的 prompt 为 1.5):不必重新计算 system prompt 的键值缓存
# Production vLLM generation setup
from vllm import LLM, SamplingParams

engine = LLM(
    model="./policy_checkpoint",
    tensor_parallel_size=4,           # TP=4 per instance
    gpu_memory_utilization=0.92,      # Leave headroom for KV cache
    max_num_batched_tokens=16384,     # Max tokens in flight
    max_num_seqs=256,                 # Max concurrent sequences
    dtype="bfloat16",
    enable_prefix_caching=True,       # Cache system prompt KV
    speculative_model="./draft_1B",   # Speculative decoding
    num_speculative_tokens=5,
    block_size=16,                    # PagedAttention block size
    swap_space=4,                     # GB swap space for preemption
)

# Generate responses for RLHF batch
sampling_params = SamplingParams(
    temperature=0.7, top_p=0.9, max_tokens=512,
    logprobs=1,  # Need log-probs for PPO ratio calculation
)
outputs = engine.generate(prompts, sampling_params)
# Extract: responses, log_probs for each token (needed for PPO/GRPO)
解耦式架构:生产级设计
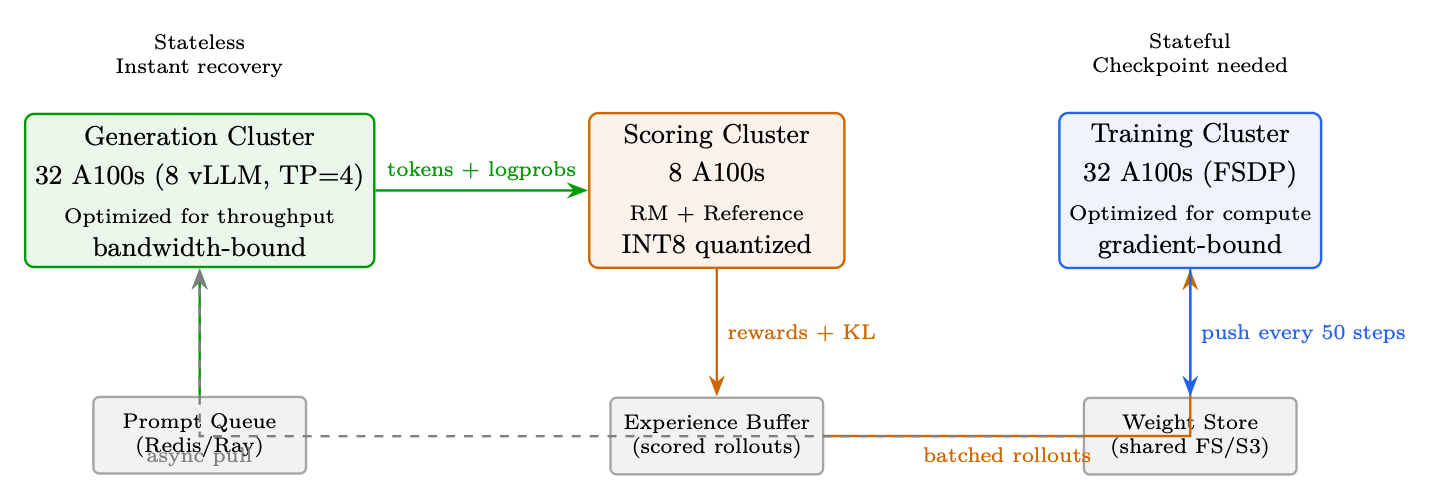
DeepSpeed-Chat [410] 和 OpenRLHF [148] 等生产级 RLHF 系统采用解耦式架构,把生成、打分和训练分离到可独立扩展的集群中。
权重同步策略
策略过时率带宽质量影响同步(每一步)0 步140 GB/step理想但太慢周期性(每 50 步)平均 25 步摊销后 2.8 GB/step2% 质量损失增量压缩(INT8)平均 25 步0.4 GB/step3% 质量损失异步流式5–10 步14 GB/step(后台)1% 质量损失
显存优化技术
ZeRO 阶段分片对象每 GPU 显存(70B,8 块 GPU)无(数据并行)无(完整副本)每 GPU 560GB(不可行)ZeRO-1仅优化器状态175GBZeRO-2优化器状态 + 梯度105GBZeRO-3(FSDP)优化器 + 梯度 + 参数70GB(能放进 A100-80GB!)
其他技术:
- 梯度检查点[49]:不必保存全部激活值,在反向传播时重新计算。可节省 60% 的激活显存,代价是多出 33% 的计算量。可选择性地只对 attention 层做检查点(显存占用大),保留 FFN 激活值(重新计算代价高)。
- 混合精度[255]:前向用 BF16(每参数 2 字节),优化器状态用 FP32(m、v 各 4 字节)。主权重用 FP32 做累加。
- CPU 卸载(ZeRO-Infinity [305]):把优化器状态移到 CPU 内存。可节省 50% 显存,但会慢 2–3(PCIe 64GB/s 瓶颈)。
- 激活值卸载:前向时把激活值移到 CPU,反向时再取回。仅在显存真正吃紧时使用。
- Flash Attention[64, 65]:attention 的显存为 O() 而不是 O()。速度快 2–4,且对长序列能大幅节省显存。
FlashAttention 对 RLHF 的影响
# DeepSpeed ZeRO-3 configuration for 70B RLHF training
ds_config = {
    "bf16": {"enabled": True},
    "zero_optimization": {
        "stage": 3,
        "overlap_comm": True,                    # Overlap communication with compute
        "contiguous_gradients": True,            # Better memory layout
        "reduce_scatter": True,                  # More efficient than allreduce
        "reduce_bucket_size": 5e7,               # 50M params per bucket
        "prefetch_bucket_size": 5e7,             # Prefetch next bucket
        "param_persistence_threshold": 1e5,      # Keep small params on all GPUs
        "offload_optimizer": {"device": "cpu", "pin_memory": True},  # CPU offload
        "sub_group_size": 1e9,                   # Reduce fragmentation
    },
    "gradient_accumulation_steps": 4,
    "gradient_clipping": 1.0,
    "train_micro_batch_size_per_gpu": 2,
    "wall_clock_breakdown": True,
}
大规模容错
生产级容错栈:
- 探测:NCCL 超时(60s)、GPU 心跳(10s)、NVML 健康监控、ECC 错误计数。
- Checkpoint:每 50–100 步异步保存。非阻塞(后台线程)。保存内容:模型权重、优化器状态(Adam m/v)、调度器状态、RNG 状态、KL 系数、replay buffer。保留最近 3 个 checkpoint。耗时:70B 约 30s(并行写入 NVMe)。
- 恢复:(a) 生成集群无状态,直接重启并加载最新权重。(b) 训练集群:加载 checkpoint,剔除故障节点重建 NCCL 进程组,重新分配 FSDP 分片,从最近 checkpoint 续训。
- 弹性训练:Torch Elastic / Kubernetes 自动扩缩。几分钟内替换故障节点。训练以 块 GPU 暂时继续。
- 预防:训练前做 GPU 健康预筛(跑 GEMM 压测)。热备机待命。冗余网络通路(双轨 InfiniBand)。
端到端延迟拆解
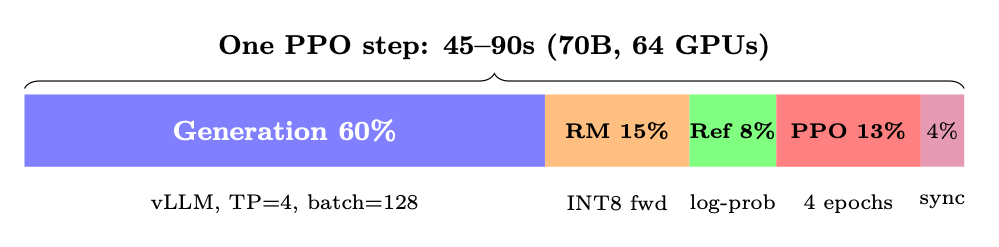
阶段用时(70B)受限于优化手段生成(128512 tok)30–45s显存带宽vLLM、推测解码、INT8Reward 打分5–8s算力(批量前向)INT8 RM、batch=128Reference log-prob4–6s算力(批量前向)INT8 ref,或 LoRA(免费)PPO 更新(4 个 epoch)8–12s算力(反向)FSDP、FlashAttention权重同步0–3s网络(异步)Delta 压缩、异步合计(单体式)50–75s合计(解耦 + 重叠)35–50s生成与上一步训练重叠
监控与可观测性
网络拓扑与通信模式
高效的分布式训练要求理解连接 GPU 的分层通信网络。现代集群采用两级架构:超高速的节点内链路,以及较慢但可扩展的节点间网络。
节点内:NVLink 与 NVSwitch
| 代际 | 每链路带宽 | 每 GPU 链路数 | 总带宽 | 平台 |
|---|---|---|---|---|
| NVLink 3.0 | 50 GB/s | 12 | 600 GB/s | A100(DGX A100) |
| NVLink 4.0 | 50 GB/s | 18 | 900 GB/s | H100(DGX H100) |
| NVLink 5.0 | 100 GB/s | 18 | 1800 GB/s | B200(DGX B200) |
表 11.5:NVLink 各代及其对 LLM 训练的影响
在单个节点内(通常 8 块 GPU),NVSwitch 在任意 GPU 对之间提供全二分带宽(full-bisection bandwidth)。这意味着任意 GPU 可以同时以全 NVLink 速率与任意其他 GPU 通信——这对张量并行(Tensor Parallelism)至关重要,因为每层都需要在 8 块 GPU 间做 AllReduce。
节点间:InfiniBand 与 RoCE
对于跨节点的 FSDP/ZeRO-3 AllGather 与 ReduceScatter 操作,节点间网络是主导因素。
| 技术 | 带宽 | 延迟 | 备注 |
|---|---|---|---|
| InfiniBand NDR | 400 Gb/s(50 GB/s) | 1–2 s | 黄金标准,RDMA,无损 |
| InfiniBand NDR(双轨) | 800 Gb/s(100 GB/s) | 1–2 s | 用于 H100 集群 |
| RoCE v2 | 100–400 Gb/s | 2–5 s | 更便宜,需要 PFC/ECN 调优 |
| Ethernet(TCP) | 100–400 Gb/s | 10–50 s | 不适用于 16 GPU 的训练 |
表 11.6:LLM 训练集群的节点间网络选项
通信原语及其代价
理解每种集合通信在何时被使用,有助于诊断瓶颈:
| 集合通信 | 数据量 | 使用方 | 使用时机 |
|---|---|---|---|
| AllReduce | TP、DP | 在各 GPU 间对梯度或激活求和 | |
| AllGather | FSDP 前向 | 在 matmul 之前重建完整参数张量 | |
| ReduceScatter | FSDP 反向 | 反向传播后分发梯度分片 | |
| 广播(Broadcast) | PP | 将激活发送到下一个流水线阶段 | |
| Send/Recv | PP | 相邻阶段之间的点对点通信 |
表 11.7:分布式 LLM 训练中的 NCCL 集合通信操作
其中 是消息大小(字节), 是参与方数量。
网络拓扑设计
生产集群采用 胖树(fat-tree) 或 轨道优化(rail-optimized) 拓扑:
- 胖树(fat-tree):每一层都具备全二分带宽。任意节点都能以全速与任意其他节点通信。成本高(交换机数量多),但灵活性最大。
- 轨道优化(rail-optimized):每个节点上的 GPU 都连接到同一台叶子交换机(「轨道 」)。同一轨道内的 AllReduce 代价低,跨轨道流量代价高。Meta 的 RSC 与 Google 的 TPU pod 采用了这种设计。
- 3D torus / Dragonfly:用于 HPC 集群(Frontier、Aurora)。拓扑感知的任务放置至关重要。
训练吞吐与模型 FLOPs 利用率
衡量训练效率:MFU
模型 FLOPs 利用率(Model FLOPs Utilization, MFU)[55] 是衡量训练效率的标准指标:
对于一个有 个参数、序列长度为 、batch size 为 的 transformer:
系数 6 来自:2(乘加) 3(前向 + 反向,其中反向 前向)。第二项对应 attention 的 开销。
| 模型 | 硬件 | MFU | Tokens/秒/GPU | 配置 |
|---|---|---|---|---|
| LLaMA-7B | 8A100 | 57% | 3,200 | FSDP、FlashAttn、BF16 |
| LLaMA-13B | 16A100 | 52% | 1,750 | FSDP、FlashAttn、BF16 |
| LLaMA-70B | 64A100 | 45% | 380 | FSDP+TP=8、FlashAttn |
| GPT-4(估计值) | 10,000+ H100 | 40–50% | — | 3D 并行 |
| PaLM-540B | 6144 TPUv4 | 46% | — | DP+TP+PP |
表 11.8:不同规模与硬件下的 MFU 基准
算力最优的 batch 设计
有效 batch size 与硬件利用率之间的相互作用并不直观:
- 过小:GPU 利用率不足(算术强度低),通信占主导。
- 过大:每个 Token 的学习收益递减(超过临界 batch size),浪费算力。
- 最佳区间:即 临界 batch size(critical batch size),此时梯度噪声与梯度信号相当。对 LLM 而言,为 –M Token [250]。
具体到 RLHF,batch 中包含的是 rollout(而不只是 Token):
典型的生产取值: 个 prompt,– 条生成结果,– 个 Token, 每步 32K–256K Token。
Profiling 与瓶颈诊断
关键 profiling 工具及其能揭示的问题:
工具采集内容最适用场景torch.profilerkernel 耗时、显存定位慢算子与显存泄漏NVIDIA Nsight Systems完整 GPU 时间线可视化重叠情况与 kernel 间的空隙nccl_debug=INFO集合通信的大小/耗时诊断通信瓶颈torch.cuda.memory_stats内存分配模式定位碎片与峰值占用DeepSpeed Flops Profiler逐层 FLOPs识别负载不均衡py-spy / scaleneCPU profiling数据加载、分词瓶颈
成本分析与云端部署
理解 RLHF 训练的经济性对规划至关重要。
硬件成本对比
| GPU | 按需/小时 | Spot/小时 | 显存 | 适用场景 |
|---|---|---|---|---|
| A100 80GB | $2.50–3.50 | $1.00–1.50 | 80 GB HBM2e | 预算有限的训练、生成集群 |
| H100 80GB | $4.00–6.00 | $2.00–3.00 | 80 GB HBM3 | 生产训练 |
| H200 141GB | $6.00–8.00 | — | 141 GB HBM3e | 大上下文、少 GPU 的配置 |
| MI300X 192GB | $3.50–5.00 | $1.50–2.50 | 192 GB HBM3 | 高性价比替代方案 |
表 11.9:RLHF 训练的云 GPU 大致成本(2024–2025 年价格)
RLHF 训练成本估算
成本优化策略
- Spot/可抢占实例:可节省 50–70%。需要健壮的 checkpoint 机制(每 5 分钟保存一次)。
- 规格匹配:生成(显存带宽受限)不要用 H100;推理场景下 A100 的每美元 Token 数与 H100 相近。
- 量化推理:生成与打分使用 INT8/FP8,可让这些集群的 GPU 数量减半。
- 渐进式训练:先用 8B 代理模型做 reward 工程与调试($200),再扩展到 70B。
- 用 LoRA 实现无 reference:完全省去 reference 模型(显存减少 50%)。
- 先短序列:按 2565121024 Token 的课程逐步加长,可节省 40% 算力。
分布式 Checkpointing
在大规模场景下,朴素的 checkpointing 会成为瓶颈。带优化器状态的 70B 模型每次 checkpoint 需要保存 840 GB(FP32 主权重(master weights) + Adam m + v)。
Checkpointing 策略
| 策略 | 保存耗时(70B) | 每个 ckpt 的存储 | 特点 |
|---|---|---|---|
| 同步(所有 rank) | 30–60s(阻塞) | 420 GB | 简单,但会阻塞训练 |
| 异步(后台拷贝) | 1s(非阻塞) | 420 GB | 与下一步重叠 |
| 增量(delta) | 1s | 5–20 GB | 只保存发生变化的参数 |
| 分片(FSDP 原生) | 5–10s | 420 GB 分片 | 每个 rank 保存自己的分片 |
表 11.10:大规模 RLHF 的 checkpoint 方案
用 torch.distributed.checkpoint 做生产级 Checkpointing
import torch.distributed.checkpoint as dcp
from torch.distributed.checkpoint.state_dict import get_state_dict, StateDictOptions

# Save: each rank writes its shard in parallel
state_dict = {"model": get_state_dict(model, options=StateDictOptions(full_state_dict=False))}
dcp.save(
    state_dict=state_dict,
    storage_writer=dcp.FileSystemWriter("/mnt/checkpoints/step_5000"),
    planner=dcp.DefaultSavePlanner(),  # Handles FSDP sharding automatically
)

# Async save: non-blocking, runs in background thread
future = dcp.async_save(
    state_dict=state_dict,
    storage_writer=dcp.FileSystemWriter("/mnt/checkpoints/step_5000"),
)
# Training continues immediately; future.result() blocks only if needed
硬件选型指南
选择合适的硬件取决于模型规模、预算与训练阶段。
| 模型规模 | 训练阶段 | 推荐硬件 | 配置 |
|---|---|---|---|
| 7B | SFT + RLHF | 1–2 A100 | 单节点,无需并行 |
| 7–13B | SFT + RLHF | 4–8 A100 | FSDP,生成可选 TP=2 |
| 13–34B | SFT + RLHF | 8–16 A100/H100 | FSDP + 生成用 TP=4 |
| 70B | RLHF(完整) | 32–64 A100/H100 | 解耦,FSDP + TP=8 |
| 70B | RLHF(LoRA) | 8–16 A100/H100 | 无 ref 模型,LoRA adapter |
| 100B | RLHF | 128+ H100 | 3D 并行(TP+PP+DP) |
表 11.11:按模型规模与训练阶段给出的硬件建议
RL 训练的优化器配置
与预训练或监督微调(Supervised Fine-Tuning, SFT)相比,RL 训练(PPO、GRPO、DPO)对优化器提出了独特要求。Loss 曲面是非平稳的(策略会改变所生成的数据),梯度噪声更大(reward 信号方差),训练也更容易出现灾难性遗忘或奖励作弊(reward hacking)。本节汇总 RL 专用的优化器指导,默认优化器为 AdamW [239]。
为什么 RL 需要不同的优化器设置
各 RL 方法的推荐超参
| 方法 | 优化器 | LR | WD | 预热 | 调度 |
|---|---|---|---|---|---|
| DPO | AdamW | 0.0 | 50 步 | 恒定或线性 | |
| PPO(策略) | AdamW | 0.0 | 20 步 | 恒定 | |
| PPO(评论家) | AdamW | 0.0 | 20 步 | 恒定 | |
| GRPO | AdamW | 0.0 | 20 步 | 恒定 |
表 11.12:RL 训练各阶段的优化器设置。所有配置均使用 、、、max_grad_norm=1.0,BF16。
RL 用 Beta-2 = 0.95:更快的自适应
Adam 默认的 对二阶矩有很长的记忆(有效窗口约 1000 步)。在 RL 训练中,Loss 曲面随策略演化快速变化——1000 步之前的梯度方差已经无关紧要。使用 可以把窗口缩短到约 20 步,使自适应学习率能快速响应变化的梯度统计量。
RL 的混合精度:FP32 Master 权重至关重要
RL 训练对数值精度尤为敏感:
- 梯度噪声更大——小的更新量必须在多步之间精确累积
- 学习率非常小(–),使得
- BF16 的尾数(7 位 0.8% 的相对精度)无法表示相对于量级为 的权重而言量级为 的更新
RL 训练务必使用 FP32 主权重(master weights)。 仅用 BF16 训练(不保留 FP32 副本)会让 PPO/GRPO 在 100–500 步后稳定地出现 reward 崩塌。
梯度裁剪对 RL 至关重要
在 PPO 与 GRPO 中,reward 信号可能波动很大,尤其是在训练早期。一个糟糕的 batch 就可能产生范数为 的梯度,足以彻底破坏模型权重。max_grad_norm=1.0 是标准设置。对 SFT 而言,裁剪不那么关键,但仍建议使用。
诊断 RL 训练的不稳定性
HuggingFace TRL 的 RL 配置
TRL 库 [376] 提供了可直接用于生产的 PPO、DPO 等 LLM RL 方法实现。
from trl import PPOConfig, PPOTrainer, DPOConfig, DPOTrainer

# --- PPO Configuration ---
ppo_config = PPOConfig(
    # Optimizer (AdamW with RL-specific settings)
    learning_rate=1e-6,           # 10-100x smaller than SFT

    # PPO-specific
    ppo_epochs=4,                 # mini-batch updates per rollout
    mini_batch_size=16,
    batch_size=64,                # rollout batch size

    # Gradient control
    max_grad_norm=1.0,

    # KL penalty (replaces weight decay as regularizer)
    init_kl_coef=0.2,            # initial KL penalty coefficient
    adap_kl_ctrl=True,           # adaptive KL targeting
    target_kl=6.0,               # target KL divergence

    # Mixed precision
    bf16=True,                   # BF16 compute, FP32 master weights
)

ppo_trainer = PPOTrainer(
    model=model,
    ref_model=ref_model,
    config=ppo_config,
    tokenizer=tokenizer,
    dataset=dataset,
)

# --- DPO Configuration ---
dpo_config = DPOConfig(
    output_dir="./dpo_output",

    # Optimizer
    learning_rate=5e-7,           # even smaller than PPO
    optim="adamw_torch",
    adam_beta1=0.9,
    adam_beta2=0.95,              # shorter memory for RL
    weight_decay=0.0,            # no WD -- KL provides regularization

    # Schedule
    lr_scheduler_type="constant_with_warmup",
    warmup_steps=50,

    # Gradient control
    max_grad_norm=1.0,

    # DPO-specific
    beta=0.1,                    # KL constraint strength
    loss_type="sigmoid",         # standard DPO loss

    # Mixed precision
    bf16=True,

    # Training
    num_train_epochs=1,          # DPO typically 1 epoch
    per_device_train_batch_size=4,
    gradient_accumulation_steps=8,
)

dpo_trainer = DPOTrainer(
    model=model,
    ref_model=ref_model,
    args=dpo_config,
    train_dataset=dataset,
    tokenizer=tokenizer,
)
dpo_trainer.train()
代码清单 6:使用 TRL 的完整 PPO 与 DPO 优化器配置。
MoE 在 RL 训练中的考虑
Miles [295] 是 PyTorch 官方的大规模 LLM RL 技术栈,把 SGLang(用于高吞吐的 rollout 生成)与 Megatron-LM(用于分布式训练更新)连接起来。它同时支持分离式执行(rollout 与训练使用各自独立的 GPU 资源池,以最大化利用率)与同置执行(把两者放在同一批节点上,适合较小规模的实验)。Miles 代表了此前零散拼凑的基础设施走向标准化——正如十年前 PyTorch 本身对深度学习训练的标准化。