
构建有效的 Agent 不仅需要强大的模型和一组工具。架构——即如何编排 LLM、如何分解任务、控制流如何在各组件间流动——决定了 Agent 是否可靠、可调试且具备成本效益。本章介绍从 Anthropic、OpenAI、Google 以及开源社区的生产部署中沉淀出的经典设计模式。
工作流模式
这些模式改编自 Anthropic 对 Agent 构建模块的分类 [9],在预定义的控制流中使用 LLM。由系统(而非模型)决定执行顺序。
Prompt 链(Prompt Chaining)
最简模式:将复杂任务拆分为固定序列的 LLM 调用,将一个调用的结果作为上下文传入下一个调用。步骤之间的校验门可在错误向下游传播之前及早捕获它们。
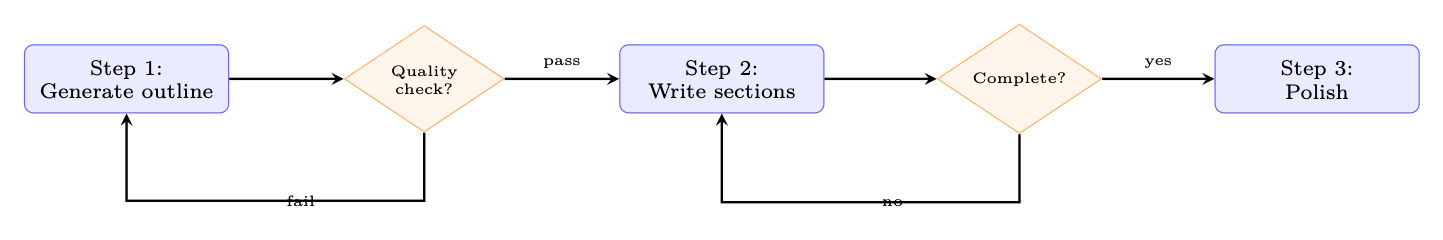
适用场景:天然顺序化的任务——内容生成、数据转换、多阶段分析。
关键优势:每一步可以使用不同的 Prompt、模型或温度。中间结果可检查、可调试。
路由(Routing)
由分类器(LLM 或传统方法)检查输入,并分派到专门的处理器。
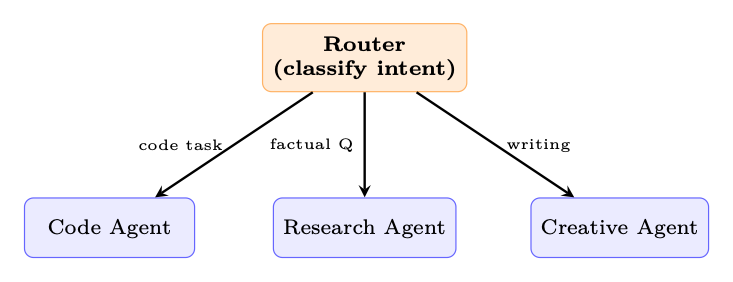
适用场景:不同任务类型对应不同的最佳 Prompt、工具或模型。如客服分诊、多模态输入处理。
并行化(Parallelization)
多个 LLM 调用并发运行,由一个程序层合并它们的输出。可分为两个子模式:
- 分段(Sectioning,fan-out):将输入划分为互不相交的块并独立处理——例如对一个代码库同时运行安全、性能和风格检查。
- 投票(Voting,冗余):用不同随机种子或温度对同一 Prompt 发起 次调用,然后通过多数投票 [368]、奖励模型打分或 LLM-as-judge 选出最佳结果。
Orchestrator-Workers
在该模式下,由 LLM 自身决定如何拆分工作。一个 Orchestrator 模型分析任务、产出子任务计划、将每个子任务分派给 Worker LLM(可能使用不同的 Prompt 或工具),最终将它们的输出合并为一致的结果。与并行化的关键区别在于:分解逻辑由模型生成,而非硬编码。
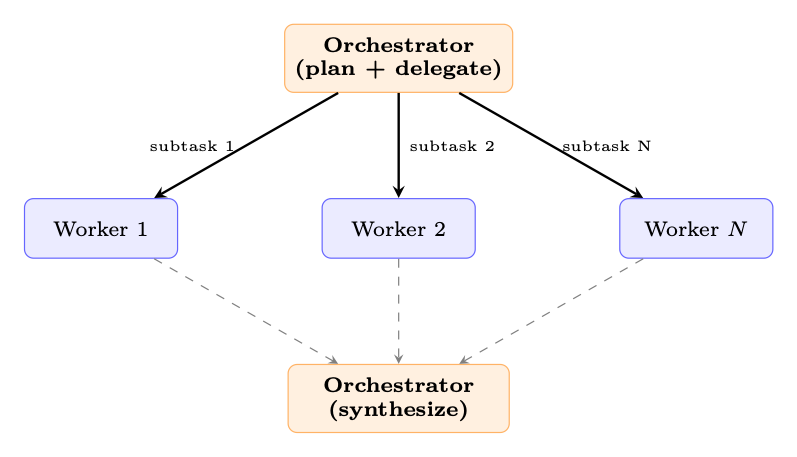
适用场景:开放式问题,子任务的数量和性质无法在设计时穷举——例如「重构这个代码库」需要先理解依赖图,再决定要修改哪些文件。
Evaluator-Optimizer
一个双模型反馈循环 [246]:生成器产出候选输出,由独立的评估器依据显式标准对其打分。若得分低于阈值,则将评估器的评论追加到生成器的上下文中,循环往复,直到达到质量标准或耗尽重试预算。
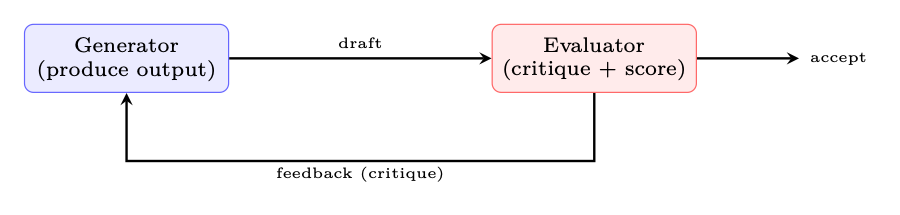
适用场景:具有明确质量标准的任务——必须通过测试的代码、必须保留语义的翻译、必须符合风格指南的写作。
自主 Agent 模式
这些模式把执行流的控制权交给 LLM 本身。
ReAct(Reason + Act)
最基础的 Agent 模式 [409]。LLM 在思考(内部推理)、行动(工具调用)和观察(处理结果)之间循环交替,直到产出最终答案。
规划型 Agent(Planning Agents)
Agent 在执行前生成显式计划,并可在执行过程中修订计划 [364]。
| 策略 | 再规划 | 特征 |
|---|---|---|
| Plan-then-Execute | 从不 | 简单;对意外结果脆弱 |
| Adaptive | 失败时 | 仅在某步失败时再规划;成本适中 |
| Continuous | 每一步 | 每次观察后完整重估;昂贵但鲁棒 |
| Hierarchical | 子计划完成时 | 高层计划固定;子计划动态生成 |
表 20.1:规划策略对比
反思与自我批判(Reflection and Self-Critique)
Agent 暂停下来评估自身轨迹并纠正方向:
- 输出校验:「这样正确吗?有没有遗漏?」
- 轨迹回顾:回顾最近 步,找出错误或低效之处。
- 策略修订:重新审视整体思路(「我是否在解决正确的问题?」)。
工具调用模式(Tool-Use Patterns)
Agent 调用工具的方式会显著影响其可靠性、延迟和成本。已有五种经典模式 [315]:
| 模式 | 描述 | 示例 |
|---|---|---|
| 单轮 | 每次 LLM 响应一次工具调用 | 带搜索的简单问答 |
| 多工具 | 单次响应中发起多个并行工具调用 | 搜索 + 计算 + 格式化 |
| 顺序 | 工具输出作为下一次工具调用的输入 | 搜索 读取 抽取 |
| 嵌套 | 工具调用触发另一个 Agent | 代码 Agent 调用 test-runner |
| 回退 | 首选工具失败;尝试替代方案 | API 抓取 缓存 |
表 20.2:工具调用模式
最简模式:模型发起一次工具调用、收到结果,然后产出最终答案。足以应对事实查询、单位换算或单次 API 查询。脚手架恰好进行两次 LLM 调用(一次决定使用哪个工具,一次综合结果)。
现代 API(OpenAI、Anthropic)允许模型在单次响应中请求多个工具调用。脚手架并发执行它们,并一并返回所有结果。这大幅降低了那些需要从多个来源获取独立信息的任务的延迟——例如同时获取股价、天气和日程。关键约束是:这些工具必须相互 独立(没有任何工具的输出需要作为另一个工具的输入)。
每个工具的输出作为下一个工具的输入,形成一条数据流水线。模型根据前一个结果决定下一个工具。在研究工作流中很常见:searchfetch_pageextract_dataanalyze。脚手架必须跟踪不断增长的上下文,并可能需要摘要中间结果以保持在预算之内。
一次工具调用会唤起一个完全独立的 Agent——它有自己的 Prompt、工具和上下文。父 Agent 将子 Agent 视为黑盒函数。这实现了专门化:研究 Agent 把代码执行委托给编码 Agent,后者可以访问 sandbox 和测试运行器。蜂群(Swarm)模式 [276] 通过专门化 Agent 之间的交接对此做了泛化。
脚手架按优先级顺序尝试工具:如果首选工具失败(超时、限流、API 错误),它会自动回退到替代方案。模型无需感知回退逻辑——脚手架会透明地处理。示例:主搜索 API 备用搜索 缓存结果 告知模型搜索不可用。
设计原则
以下原则提炼自 Anthropic 关于构建有效 Agent 的指南 [9],适用于所有模式:
- 保持简单。使用能奏效的最简架构。只在被证明必要时才增加复杂性。能解决问题的 Prompt 链,永远优于可能解决问题的多 Agent 系统。
- 透明优先于取巧。每一步都应可检查。避免隐藏状态或隐式推理。当 Agent 失败时,你需要理解为什么——不透明的架构会让调试变得不可能。
- 提供良好的工具。文档完善、类型明确、报错信息清晰的工具是效力倍增器。描述含糊的工具会被误用;而模式精确、附有使用指引的工具会被正确选择。
- 为失败做规划。每次工具调用都可能失败。在脚手架层构建重试逻辑、回退和优雅降级,这样模型就不必去推理基础设施故障。
- 使用结构化输出。约束生成(JSON schema、function calling)可以避免解析失败。产出需要正则解析的自由文本的 Agent 是脆弱的;产出经过校验的 JSON 的 Agent 则是鲁棒的。
- 用多样化输入进行测试。Agent 的行为比单轮对话更多变。同一个 Prompt 在不同运行中可能产生不同的工具调用序列。要用对抗性方式测试,覆盖边界情况、歧义请求和畸形输入。
模式选择指南
选择正确的模式取决于三个因素:(1) 任务结构的可预测程度,(2) 在延迟和成本上你能承受多少次 LLM 调用,(3) 质量是否要求迭代。把下表当作决策矩阵——从最上面(最简单)开始,只有当更简单的模式确实失败时才向下移动。
| 模式 | 复杂度 | LLM 调用次数 | 最适合 |
|---|---|---|---|
| Prompt 链 | 低 | (固定) | 顺序化任务、内容流水线 |
| 路由 | 低 | 1 + 1 | 多类型输入、分诊 |
| 并行化 | 低 | (并行) | 独立子任务、投票 |
| Orchestrator-workers | 中 | 可变 | 分解方式未知 |
| Evaluator-optimizer | 中 | 2–10(循环) | 质量至上的输出 |
| ReAct | 中 | 3–25(循环) | 通用工具使用、探索 |
| 规划型 Agent | 高 | 5–50+ | 长时程、多步骤任务 |
| 反思 | 高 | +50% 开销 | 首次尝试常常失败的任务 |
| 多 Agent | 高 | 很多 | 复杂领域、专门化 |
表 20.3:何时使用每种 Agent 设计模式
模式可以组合:一个规划型 Agent 可以在各个步骤中使用 Prompt 链,在其评审阶段内使用 evaluator-optimizer,并用路由把子任务分派给专家。真正的艺术在于知道何时停止增加层次。