
随着大语言模型从孤立的助手演化为由专业化智能体(Agent)组成的协作网络,Agent 之间如何对话这一问题已变得与它们内部如何推理同等重要。本节介绍那些使多智能体系统能够协调、委派并共同解决任何单个 Agent 都无法独立处理的问题的协议、模式与工程实践。
动机:为何 Agent 必须相互通信
推动结构化 Agent 间通信需求的力量主要有以下几股:
每个 LLM 都在有限的上下文窗口内运行。复杂的工作流——涉及数百份文档、tool 调用和推理步骤——很快会超出单一 Agent 的内存承载力。通过将任务分解到多个 Agent,每个 Agent 都在可管理的上下文中工作,而编排型 Agent 只需维护高层状态。
不同的 Agent 可针对特定领域进行微调、Prompt 设计或 tool 配置:一个可访问编译器和测试运行器的 CodeAgent、一个可访问判例数据库的 LegalAgent、一个配备统计库的 DataAgent。将子任务路由给合适的专家可同时提升质量与效率。
彼此独立的子任务可以同时分派给多个 Agent。一个研究编排器可能并行地把文献检索扇出到五个专业化 Agent,然后再综合它们的结果——大幅缩短墙钟时间。
当某个 Agent 失败时,设计良好的多智能体系统可以换用另一个 Agent 重试、回退到更简单的方案,或者升级到人工介入——而不会让整个工作流崩溃。
长时间运行的任务可能需要随着上下文转移而在 Agent 之间交接。最初的 PlannerAgent 分解目标,把子任务交给 ExecutorAgents,最后由 ReviewerAgent 校验输出——每个 Agent 只接收它恰好需要的那部分上下文。
Google A2A 协议
2025 年 4 月,Google(在 50 余家技术合作伙伴的共同贡献下)发布了 智能体到智能体(Agent-to-Agent, A2A)协议[115],这是一份用于 AI Agent 之间互操作通信的开放规范。该协议随后被捐赠给 Linux Foundation,截至 2026 年支持机构已超过 150 家。A2A 围绕一组核心原则进行设计,使其区别于早期的临时方案。
设计理念
A2A 规范明确提出了五条指导原则(根据官方规范 [115] §1.2 改编):
Agent Card
A2A 可发现性的基础是 Agent Card——一份托管在固定端点(/.well-known/agent.json)上的机器可读 JSON 清单。它声明该 Agent 能做什么、如何认证、把任务发送到何处——类似于 OpenAPI 规范,但面向的是自主 Agent 而非 REST 端点。
Agent Card 支持基于能力的路由:编排型 Agent 可以从注册中心获取 Agent Card,把一个子任务语义匹配到最合适的 Agent,并据此分派——全程无需硬编码的路由逻辑。
任务生命周期
A2A 把一切工作都建模为 Task。一个任务会经历一个明确定义的状态机:
submitted
客户端已发送任务;服务器已确认收到。
working
Agent 正在积极处理。客户端可以轮询,也可以等待 SSE 事件。
input-required
Agent 需要来自用户或调用方 Agent 的额外信息才能继续(例如一个澄清性问题、一项缺失的凭证)。
completed
任务成功完成;结果已在响应中可用。
failed
发生了不可恢复的错误;一条错误消息说明了原因。
rejected
Agent 拒绝了这个任务(例如超出其能力范围或未获授权)。在 A2A v1.0 中新增。
canceled
任务被中止,中止方可能是客户端,也可能是服务器。
基于 Server-Sent Events 的流式传输
对于会产生增量输出的任务(例如正在撰写一份长报告、正在生成一个代码文件),A2A 使用 服务器推送事件(Server-Sent Events, SSE)。客户端打开一条持久 HTTP 连接,并接收一串 JSON 事件:
长时间运行任务的推送通知
当一项任务可能耗时数分钟甚至数小时时,维持一条常开的 SSE 连接并不现实。A2A 支持 推送通知:客户端注册一个 webhook URL,服务器在任务推进过程中 POST 状态更新。
# Client registers a push notification endpoint when submitting the task
task_request = {
    "id": "task-xyz789",
    "message": {
        "role": "user",
        "parts": [{"type": "text", "text": "Analyze Q3 sales data and produce a report."}]
    },
    "pushNotification": {
        "url": "https://my-orchestrator.example.com/webhooks/a2a",
        "token": "secret-hmac-token-for-verification",
        "authentication": {
            "schemes": ["Bearer"],
            "credentials": "eyJhbGciOiJIUzI1NiJ9..."
        }
    }
}
# The server will POST TaskStatusUpdateEvent objects to the webhook URL
# as the task transitions through states.
消息格式
A2A 消息由一个 role(user 或 agent)加上一个带类型的 parts 列表(文本、文件或结构化数据)构成。完整的消息 schema、多模态示例以及上下文传递指南在第 24.5 消息格式与 Schema 节中介绍。
认证与授权
A2A 支持多种认证方案,它们在 Agent Card 中声明,并按请求逐一强制执行:
- Bearer token(JWT/OAuth 2.0):企业部署的标准做法;token 携带作用域,限定调用方 Agent 被允许请求的范围。
- API 密钥:适用于内部或可信环境的更简单方案。
- 双向 TLS(mTLS):面向高安全部署的基于证书的认证。
- OpenID Connect:联合身份,支持跨组织的 Agent 通信。
通信模式
多智能体系统会根据任务的性质、延迟要求以及参与 Agent 的数量,采用各种各样的通信模式。
请求-响应(Request-Response)
最简单的模式:Agent A 把任务发送给 Agent B,并等待一个完整响应。适用于简短、定义明确的子任务,且必须在继续之前拿到结果。
流式传输(Streaming)
Agent A 打开一条 SSE 连接;Agent B 在结果产生的过程中流式发送部分结果。非常适合长篇生成(报告、代码)、实时协作或渐进式 UI 更新。
多轮交互(Multi-Turn)
有些任务需要迭代式精化。Agent 进入 input-required 状态,编排器提供澄清,任务随后恢复。这与人类的协作工作流如出一辙:草稿 反馈 修订。
# Multi-turn: orchestrator handles input-required state
async def run_multiturn_task(client, initial_message):
    task = await client.send_task(message=initial_message)

    while task.status.state not in ("completed", "failed", "canceled"):
        if task.status.state == "input-required":
            # Agent needs clarification
            clarification_needed = task.status.message
            print(f"Agent asks: {clarification_needed}")

            # Orchestrator generates or forwards a clarifying response
            user_reply = await get_clarification(clarification_needed)

            # Send the reply to continue the task
            task = await client.send_task(
                task_id=task.id,
                message={"role": "user",
                         "parts": [{"type": "text", "text": user_reply}]}
            )
        else:
            # Still working --- poll after a delay
            await asyncio.sleep(2)
            task = await client.get_task(task.id)

    return task
广播(Broadcast)
编排器同时把同一条消息发送给多个 Agent——适用于发布宣告、分发共享上下文,或触发并行的独立工作流。
发布-订阅(Publish-Subscribe, Pub-Sub)
Agent 订阅事件通道(例如 new-document-uploaded、model-retrained)。当某个事件触发时,所有已订阅的 Agent 都会收到通知。这使生产者与消费者解耦,并支持反应式的事件驱动架构。
协商(Negotiation)
两个 Agent 交换提议与反提议,以就某个计划、资源分配或方案达成一致。这在 Agent 目标或约束各异的多智能体规划系统中很常见。
基于拍卖的任务分配(Auction-Based Task Allocation)
编排器带着需求宣告一项任务;候选 Agent 提交竞标(预计完成时间、置信度、成本);编排器把任务授标给获胜的竞标方。这使一个 Agent 池之上能够实现动态的、基于市场的负载均衡。
| 模式 | 延迟 | 最适合 |
|---|---|---|
| 请求-响应 | 低 | 简短、定义明确的子任务 |
| 流式传输 | 低(首个 token) | 长篇生成、实时 UI |
| 多轮对话 | 中 | 需要澄清的模糊任务 |
| 广播 | 低 | 共享上下文分发 |
| 发布-订阅 | 不定 | 事件驱动的反应式工作流 |
| 协商 | 中—高 | 资源受限的规划 |
| 拍卖 | 中 | 动态负载均衡 |
表 24.1:A2A 通信模式汇总。
Agent 发现与路由
在一个 Agent 能够与其他 Agent 通信之前,它必须先找到对方。Agent 发现是定位能够处理给定任务的 Agent 的过程。
Agent 注册中心
Agent 注册中心是一种目录服务,它为 Agent Card 建立索引,并提供搜索与查找 API。它有两种部署模式:
中心化注册中心
一个单一的权威注册中心(例如企业服务目录)为所有 Agent 建立索引。运维简单,但会造成单点故障,并且可能无法扩展到跨组织部署。
联合注册中心
存在多个注册中心,每个都是一个领域或组织的权威,并配有跨注册中心的搜索协议。更具韧性且更利于保护隐私,但需要标准化的联合协议。
基于能力的路由
编排器不会硬编码 Agent URL,而是执行基于能力的路由:它们向注册中心查询符合所需技能的 Agent,然后选出最匹配的一个。
class AgentRouter:
    """Routes tasks to agents based on capability matching."""

    def __init__(self, registry_url: str):
        self.registry_url = registry_url
        self._cache: dict[str, list[AgentCard]] = {}

    async def find_agents(self, required_skill: str,
                          tags: list[str] | None = None) -> list[AgentCard]:
        """Query registry for agents with the required skill."""
        params = {"skill": required_skill}
        if tags:
            params["tags"] = ",".join(tags)
        async with httpx.AsyncClient() as client:
            resp = await client.get(f"{self.registry_url}/agents", params=params)
            return [AgentCard(**card) for card in resp.json()["agents"]]

    async def route(self, task_description: str) -> AgentCard:
        """Semantically match a task description to the best available agent."""
        # Embed the task description
        task_embedding = await embed(task_description)

        # Fetch all registered agents
        all_agents = await self.find_agents(required_skill="*")

        # Score each agent by cosine similarity of task to agent description
        scored = []
        for agent in all_agents:
            agent_embedding = await embed(agent.description)
            score = cosine_similarity(task_embedding, agent_embedding)
            scored.append((score, agent))

        # Return the highest-scoring agent
        scored.sort(key=lambda x: x[0], reverse=True)
        return scored[0][1]
等价 Agent 间的负载均衡
当多个 Agent 提供相同能力时,路由器必须分发负载。常见策略包括:
- 轮询:把任务均匀分发给所有可用 Agent。
- 最少负载:路由到活动任务数最少的 Agent(需要健康/指标端点)。
- 延迟感知:路由到最近响应时间最低的 Agent。
- 亲和性优先:把相关任务路由到同一个 Agent,以利用已缓存的上下文。
版本管理与兼容性
Agent Card 包含一个 version 字段。编排器应指定最低版本要求,并在只有旧版本可用时优雅降级。推荐使用语义化版本 [293](MAJOR.MINOR.PATCH):破坏接口的变更递增 MAJOR,新增能力递增 MINOR。
消息格式与 Schema
结构化与非结构化消息
A2A 支持从完全非结构化(纯文本)到完全结构化(带类型的 JSON schema)的整个谱段。正确的选择取决于所涉及的 Agent:
| 消息类型 | 优点 | 缺点 |
|---|---|---|
| 纯文本 | 灵活、人类可读、易于生成 | 难以可靠解析,无 schema 校验 |
| 结构化 JSON | 机器可解析、可校验、带类型 | 需要 schema 约定,灵活性较差 |
| 混合(文本 + 数据) | 人类可读的意图 + 机器可解析的负载 | 构造和解析都更复杂 |
表 24.2:结构化与非结构化 A2A 消息的权衡。
多模态消息
A2A 消息由一个 role(user 或 agent)加上一个带类型的 parts 列表构成:
| Part 类型 | 字段 | 用例 |
|---|---|---|
| TextPart | text: string | 自然语言指令、响应 |
| FilePart | mimeType、uri 或 bytes | 文档、图像、音频、代码文件 |
| DataPart | data: object | 结构化 JSON(tool 结果、schema) |
表 24.3:A2A 消息的 part 类型(线上格式使用 "type": "text"|"file"|"data")。
现代 Agent 越来越多地处理非文本模态。A2A 的 FilePart 支持任意 MIME 类型,从而支持丰富的多模态工作流:
上下文传递:哪些该共享,哪些应保留
多智能体系统中的一个关键设计决策是上下文作用域:把多少对话历史和内部状态传递给子 Agent。
会话串联与关联 ID
在复杂工作流中,许多任务可能同时处于进行状态。关联 ID把跨 Agent 的相关任务串联起来:
import uuid

class WorkflowContext:
    """Carries correlation metadata through a multi-agent workflow."""

    def __init__(self, workflow_id: str | None = None):
        self.workflow_id = workflow_id or str(uuid.uuid4())
        self.span_id = str(uuid.uuid4())
        self.parent_span_id: str | None = None

    def child_context(self) -> "WorkflowContext":
        """Create a child context for a sub-task."""
        child = WorkflowContext(workflow_id=self.workflow_id)
        child.parent_span_id = self.span_id
        return child

    def to_metadata(self) -> dict:
        return {
            "x-workflow-id": self.workflow_id,
            "x-span-id": self.span_id,
            "x-parent-span-id": self.parent_span_id
        }

# Usage: attach to every A2A task submission
ctx = WorkflowContext()
task = await client.send_task(
    message=message,
    metadata=ctx.to_metadata()
)
# Sub-tasks use child contexts for tracing
sub_ctx = ctx.child_context()
协调协议
除点对点通信之外,多智能体系统还受益于更高层次的协调协议——这些结构化的交互模式使集体决策与问题求解成为可能。
合同网协议(Contract Net Protocol)
合同网协议(Contract Net Protocol, CNP)[334] 是一种经典的多智能体协调机制,已被适配到基于 LLM 的系统:
- 宣告:管理方 Agent 向所有潜在的承包方 Agent 广播任务宣告,其中包含任务要求和评估标准。
- 竞标:承包方 Agent 结合自身能力评估任务,并提交包含预计完成时间、置信度和资源需求的竞标。
- 授标:管理方选出获胜竞标(对于并行子任务也可能是多个竞标),并授予合同。
- 执行与汇报:承包方执行任务,并把结果回报给管理方。
黑板系统(Blackboard Systems)
黑板系统[135] 提供了一个共享工作区(即「黑板」),Agent 在上面发布部分解、观察和假设。其他 Agent 监视黑板,在能够贡献价值时参与进来——这是一种机会主义的问题求解方式。
黑板系统非常适合那些求解路径事先未知、且不同 Agent 可能在不同阶段做出贡献的问题——例如科学假设生成、复杂调试或多源情报分析。
共识协议(Consensus Protocols)
当多个 Agent 必须就某个决策达成一致时(例如执行哪个计划、某个结果是否正确),共识协议提供了结构化的投票机制:
简单多数投票
每个 Agent 投票;获得 选票的选项获胜。速度快,但如果 Agent 共享同一个基础模型,就容易受到相关性错误的影响。
加权投票
投票按 Agent 的置信度或历史准确率加权。更稳健,但需要经过校准的置信度估计。
基于法定人数
一项决策至少需要 个 Agent 中 个的同意。它提供了容错能力:最多 个 Agent 失败或持异议也不会造成阻塞。
德尔菲方法
Agent 投票、查看匿名化结果、修订自己的投票,如此重复直至收敛。这可以减少锚定偏差,鼓励真正的审慎讨论。
async def quorum_vote(agents: list[AgentCard], question: str,
                      options: list[str], quorum: int) -> str | None:
    """Run a quorum vote across agents. Returns winning option or None."""
    votes = await asyncio.gather(*[
        ask_agent_to_vote(agent, question, options)
        for agent in agents
    ])

    counts: dict[str, int] = {}
    for vote in votes:
        if vote in options:
            counts[vote] = counts.get(vote, 0) + 1

    # Return first option that reaches quorum
    for option, count in sorted(counts.items(), key=lambda x: -x[1]):
        if count >= quorum:
            return option
    return None  # No quorum reached
领导者选举(Leader Election)
在动态多智能体系统中,leader(编排器)可能需要在运行时选举产生——例如当原编排器失败,或者 Agent 在没有预先指定协调者的情况下自组织时。经典的分布式系统算法(Bully、Ring)可以适配到 Agent 网络,Agent 之间交换能力评分或优先级 token,以选举出最有能力的可用 Agent 作为 leader。
A2A 与 MCP:互补的协议
一个常见的困惑来源是 A2A 与 模型上下文协议(Model Context Protocol, MCP)[10] 之间的关系。这两个协议是互补的,而不是相互竞争的:
维度MCPA2A参与者Agent 工具/资源Agent Agent智能性只有一方(Agent)具备智能双方都具备智能状态性通常是 stateless 的 tool 调用带生命周期的有状态任务流式传输有限(tool 结果)一等的 SSE 流式传输发现机制tool 清单Agent Card认证模型由服务器控制相互认证,OAuth 2.0典型延迟毫秒级秒级到分钟级用例「搜索网页」「运行 SQL」「委派给专家」
何时使用哪一种
- 当远程端点是确定性函数时使用 MCP:数据库查询、API 调用、代码执行沙箱。Agent 完全掌控这次交互。
- 当远程端点需要就请求推理时使用 A2A:解释含糊的指令、做出判断、使用自己的 tool,或者进行多轮对话。
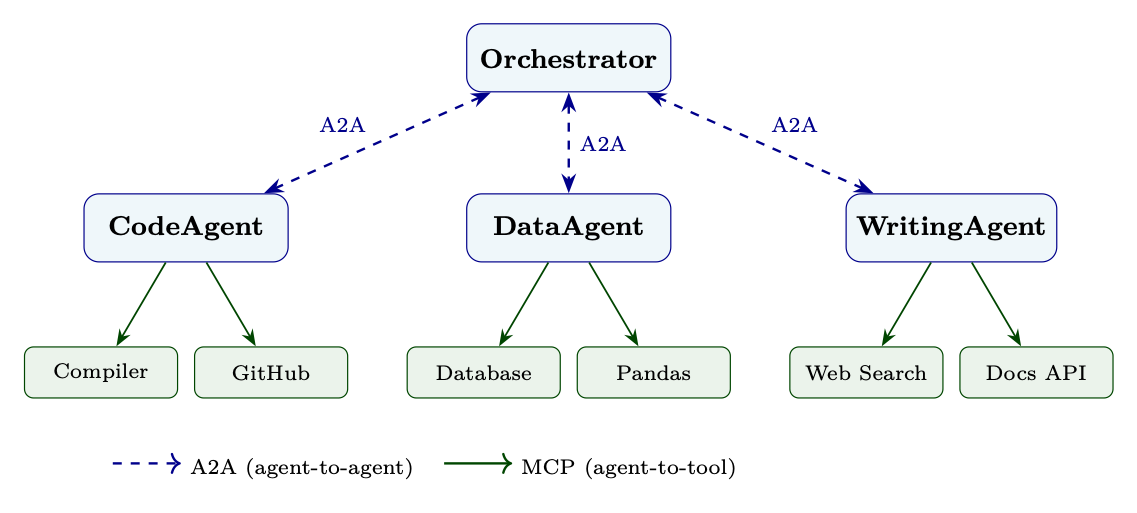
- 在同一个系统中两者都用:编排型 Agent 用 A2A 委派给专家 Agent,每个专家 Agent 用 MCP 访问自己的 tool。
组合架构
在生产环境的多智能体系统中,A2A 与 MCP 在不同层次上协同工作:A2A负责 Agent 间的委派与协调(对等体之间的水平通信),而 MCP负责每个 Agent 与其 tool 和数据源的连接(与各项能力之间的垂直集成)。这种关注点分离是构建可扩展 Agent 架构的关键。
多 Agent 系统中的安全与信任
多智能体系统带来独特的安全挑战。当 Agent A 委派给 Agent B,Agent B 又委派给 Agent C 时,这条信任链必须被谨慎管理。
Agent 身份验证
每个 Agent 都必须有可验证的身份。可选方案包括:
- JWT token[172],由受信任的身份提供方签名,携带 Agent 的 ID、签发者和过期时间。接收方 Agent 使用该提供方的公钥进行验证。
- mTLS 证书[36],由内部 CA 签发,同时提供认证和传输加密。
- 去中心化标识符(DID)[61],用于不存在单一受信任权威的跨组织场景。
消息完整性与加密
- 所有 A2A 通信都应通过 TLS 1.3[307] 进行,以防止窃听和中间人攻击。
- 对于敏感负载,端到端加密(例如 JWE)确保中间基础设施(负载均衡器、代理)无法读取消息内容。
- 消息签名(JWS)提供不可否认性:接收方 Agent 能够证明某条特定消息来自某个特定发送方。
授权 scope
并非每个 Agent 都应该能够让其他任何 Agent 做任何事。OAuth 2.0 授权作用域 [133] 界定了这些边界:
# Example OAuth 2.0 scopes for a DataAgent
SCOPES = {
    "data:read":        "Read data from connected databases",
    "data:write":       "Write or modify data in connected databases",
    "data:export":      "Export data to external systems",
    "analysis:run":     "Execute statistical analyses",
    "analysis:schedule":"Schedule recurring analyses",
    "admin:config":     "Modify agent configuration"
}

# A ReportingAgent might hold only: data:read, analysis:run
# An ETL pipeline agent might hold: data:read, data:write, data:export
# Only a human admin holds: admin:config

class A2AServer:
    def verify_authorization(self, token: str, required_scope: str) -> bool:
        """Verify that the calling agent holds the required scope."""
        claims = jwt.decode(token, self.public_key, algorithms=["RS256"])
        granted_scopes = claims.get("scope", "").split()
        if required_scope not in granted_scopes:
            raise PermissionError(
                f"Caller lacks required scope '{required_scope}'. "
                f"Granted: {granted_scopes}"
            )
        return True
审计轨迹与问责
每个 A2A 服务器都应输出结构化的审计日志:
@dataclass
class A2AAuditEvent:
    timestamp: str          # ISO 8601
    workflow_id: str        # Correlation ID for the top-level workflow
    span_id: str            # This task's span
    parent_span_id: str     # Calling task's span (for delegation chains)
    caller_agent_id: str    # Verified identity of the calling agent
    callee_agent_id: str    # This agent's identity
    task_id: str
    skill_invoked: str
    authorization_scopes: list[str]
    outcome: str            # "completed" | "failed" | "rejected"
    duration_ms: int
    error_code: str | None
实现示例:多 Agent 研究工作流
下面的示例演示了一个使用 A2A 的完整多智能体研究工作流:一个 OrchestratorAgent 分解研究问题,委派给专家 Agent,并综合它们的结果。
"""
Multi-agent research workflow using A2A protocol.
Demonstrates: Agent Cards, A2A client/server, task lifecycle,
multi-turn interaction, and agent handoffs.
"""

import asyncio
import json
import uuid
from collections.abc import AsyncIterator
from datetime import datetime, timedelta, timezone

import httpx
from fastapi import FastAPI, HTTPException, Request
from fastapi.responses import StreamingResponse
from pydantic import BaseModel, Field

# -- Data Models --------------------------------------------------------------

class Part(BaseModel):
    type: str           # "text" | "file" | "data"
    text: str | None = None
    data: dict | None = None
    mimeType: str | None = None
    uri: str | None = None

class Message(BaseModel):
    role: str           # "user" | "agent"
    parts: list[Part]

class TaskStatus(BaseModel):
    state: str          # submitted | working | input-required | completed | failed
    message: str | None = None
    timestamp: str = Field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

class Artifact(BaseModel):
    parts: list[Part]
    index: int = 0
    append: bool = False
    lastChunk: bool = True

class Task(BaseModel):
    id: str
    status: TaskStatus
    messages: list[Message] = []
    artifacts: list[Artifact] = []
    metadata: dict = {}

# -- A2A Client (HTTP/REST binding) --------------------------------------------
# Note: A2A v1.0 defines three protocol bindings: JSON-RPC 2.0, gRPC, and
# HTTP+JSON/REST. This example uses the REST binding for readability.

class A2AClient:
    """Client for sending tasks to A2A-compliant agents."""

    def __init__(self, agent_url: str, auth_token: str):
        self.agent_url = agent_url.rstrip("/")
        self.headers = {
            "Authorization": f"Bearer {auth_token}",
            "Content-Type": "application/json"
        }

    async def get_agent_card(self) -> dict:
        """Fetch the agent's capability card."""
        async with httpx.AsyncClient() as client:
            resp = await client.get(
                f"{self.agent_url}/.well-known/agent.json",
                headers=self.headers
            )
            resp.raise_for_status()
            return resp.json()

    async def send_task(self, message: Message,
                        task_id: str | None = None,
                        metadata: dict | None = None) -> Task:
        """Submit a task and return the initial task object."""
        payload = {
            "id": task_id or str(uuid.uuid4()),
            "message": message.model_dump(),
            "metadata": metadata or {}
        }
        async with httpx.AsyncClient() as client:
            resp = await client.post(
                f"{self.agent_url}/tasks/send",
                json=payload,
                headers=self.headers,
                timeout=30.0
            )
            resp.raise_for_status()
            return Task(**resp.json())

    async def stream_task(self, message: Message,
                          metadata: dict | None = None) -> AsyncIterator[dict]:
        """Submit a task and stream SSE events."""
        payload = {
            "id": str(uuid.uuid4()),
            "message": message.model_dump(),
            "metadata": metadata or {}
        }
        async with httpx.AsyncClient() as client:
            async with client.stream(
                "POST",
                f"{self.agent_url}/tasks/sendSubscribe",
                json=payload,
                headers={**self.headers, "Accept": "text/event-stream"},
                timeout=300.0
            ) as response:
                async for line in response.aiter_lines():
                    if line.startswith("data: "):
                        event_data = json.loads(line[6:])
                        yield event_data
                        if event_data.get("final"):
                            break

    async def get_task(self, task_id: str) -> Task:
        """Poll for task status."""
        async with httpx.AsyncClient() as client:
            resp = await client.get(
                f"{self.agent_url}/tasks/{task_id}",
                headers=self.headers
            )
            resp.raise_for_status()
            return Task(**resp.json())

    async def wait_for_completion(self, task: Task,
                                  poll_interval: float = 2.0) -> Task:
        """Poll until task reaches a terminal state."""
        terminal_states = {"completed", "failed", "canceled"}
        while task.status.state not in terminal_states:
            await asyncio.sleep(poll_interval)
            task = await self.get_task(task.id)
        return task

# -- A2A Server (FastAPI) -----------------------------------------------------

class ResearchAgent:
    """
    A specialist research agent that searches literature and
    summarizes findings on a given topic.
    """

    AGENT_CARD = {
        "name": "ResearchAgent",
        "description": "Searches academic literature and synthesizes research findings.",
        "url": "https://research-agent.example.com/a2a",
        "version": "1.0.0",
        "capabilities": {
            "streaming": True,
            "pushNotifications": False,
            "stateTransitionHistory": True
        },
        "authentication": {"schemes": ["Bearer"]},
        "skills": [{
            "id": "literature-search",
            "name": "Literature Search",
            "description": "Search and summarize academic papers on a topic.",
            "tags": ["research", "literature", "academic", "papers"],
            "examples": [
                "Summarize recent papers on transformer attention mechanisms.",
                "What does the literature say about RLHF for code generation?"
            ],
            "inputModes": ["text"],
            "outputModes": ["text", "data"]
        }]
    }

    def __init__(self):
        self.tasks: dict[str, Task] = {}
        self.app = FastAPI(title="ResearchAgent A2A Server")
        self._register_routes()

    def _register_routes(self):
        @self.app.get("/.well-known/agent.json")
        async def agent_card():
            return self.AGENT_CARD

        @self.app.post("/tasks/send")
        async def send_task(request: Request):
            body = await request.json()
            task = await self._create_and_run_task(body)
            return task.model_dump()

        @self.app.post("/tasks/sendSubscribe")
        async def send_subscribe(request: Request):
            body = await request.json()
            return StreamingResponse(
                self._stream_task(body),
                media_type="text/event-stream"
            )

        @self.app.get("/tasks/{task_id}")
        async def get_task(task_id: str):
            if task_id not in self.tasks:
                raise HTTPException(status_code=404, detail="Task not found")
            return self.tasks[task_id].model_dump()

    async def _create_and_run_task(self, body: dict) -> Task:
        task_id = body.get("id", str(uuid.uuid4()))
        message = Message(**body["message"])

        task = Task(
            id=task_id,
            status=TaskStatus(state="submitted"),
            messages=[message],
            metadata=body.get("metadata", {})
        )
        self.tasks[task_id] = task

        # Run asynchronously
        asyncio.create_task(self._execute_task(task_id))
        return task

    async def _execute_task(self, task_id: str):
        task = self.tasks[task_id]
        task.status = TaskStatus(state="working")

        try:
            # Extract the research question from the message
            question = task.messages[0].parts[0].text

            # Simulate literature search (replace with real search tool)
            await asyncio.sleep(1)  # Simulated latency
            findings = await self._search_literature(question)

            # Produce artifact
            task.artifacts = [Artifact(parts=[
                Part(type="text", text=findings["summary"]),
                Part(type="data", data={"papers": findings["papers"],
                                        "query": question})
            ])]
            task.status = TaskStatus(state="completed")

        except Exception as e:
            task.status = TaskStatus(state="failed", message=str(e))

        self.tasks[task_id] = task

    async def _search_literature(self, question: str) -> dict:
        """Placeholder: in production, calls a real search API."""
        return {
            "summary": f"Based on a search of recent literature regarding "
                       f"'{question}', key findings include: ...",
            "papers": [
                {"title": "Attention Is All You Need", "year": 2017,
                 "relevance": 0.95},
                {"title": "RLHF: Training Language Models to Follow Instructions",
                 "year": 2022, "relevance": 0.88}
            ]
        }

    async def _stream_task(self, body: dict) -> AsyncIterator[str]:
        task = await self._create_and_run_task(body)

        # Stream status updates
        yield f"data: {json.dumps({'id': task.id, 'status': {'state': 'submitted'}, 'final': False})}\n\n"
        yield f"data: {json.dumps({'id': task.id, 'status': {'state': 'working'}, 'final': False})}\n\n"

        # Wait for completion
        while task.status.state not in ("completed", "failed", "canceled"):
            await asyncio.sleep(0.5)
            task = self.tasks[task.id]

        # Stream the artifact
        if task.artifacts:
            for part in task.artifacts[0].parts:
                event = {
                    "id": task.id,
                    "artifact": {
                        "parts": [part.model_dump()],
                        "index": 0,
                        "append": False,
                        "lastChunk": True
                    },
                    "final": False
                }
                yield f"data: {json.dumps(event)}\n\n"

        # Final status
        yield f"data: {json.dumps({'id': task.id, 'status': task.status.model_dump(), 'final': True})}\n\n"

# -- Orchestrator: Multi-Agent Workflow ----------------------------------------

class ResearchOrchestrator:
    """
    Orchestrates a multi-agent research workflow:
    1. Decomposes the research question into sub-questions
    2. Dispatches each sub-question to a ResearchAgent
    3. Synthesizes results into a final report
    """

    def __init__(self, research_agent_url: str, auth_token: str):
        self.research_client = A2AClient(research_agent_url, auth_token)
        self.workflow_id = str(uuid.uuid4())

    async def run(self, research_question: str) -> str:
        print(f"[Orchestrator] Starting workflow {self.workflow_id}")
        print(f"[Orchestrator] Question: {research_question}")

        # Step 1: Decompose into sub-questions
        sub_questions = self._decompose(research_question)
        print(f"[Orchestrator] Decomposed into {len(sub_questions)} sub-questions")

        # Step 2: Dispatch sub-questions in parallel
        tasks = await asyncio.gather(*[
            self.research_client.send_task(
                message=Message(role="user", parts=[Part(type="text", text=q)]),
                metadata={"workflowId": self.workflow_id, "subQuestion": i}
            )
            for i, q in enumerate(sub_questions)
        ])

        # Step 3: Wait for all tasks to complete
        completed_tasks = await asyncio.gather(*[
            self.research_client.wait_for_completion(task)
            for task in tasks
        ])

        # Step 4: Check for failures
        failed = [t for t in completed_tasks if t.status.state == "failed"]
        if failed:
            print(f"[Orchestrator] Warning: {len(failed)} sub-tasks failed")

        # Step 5: Synthesize results
        findings = []
        for task, question in zip(completed_tasks, sub_questions):
            if task.status.state == "completed" and task.artifacts:
                summary = task.artifacts[0].parts[0].text
                findings.append(f"### {question}\n{summary}")

        report = self._synthesize(research_question, findings)
        print(f"[Orchestrator] Workflow complete. Report: {len(report)} chars")
        return report

    def _decompose(self, question: str) -> list[str]:
        """Decompose a complex question into focused sub-questions."""
        # In production: use an LLM to decompose
        return [
            f"What are the foundational methods for: {question}?",
            f"What are the most recent advances in: {question}?",
            f"What are the open challenges and limitations in: {question}?"
        ]

    def _synthesize(self, question: str, findings: list[str]) -> str:
        """Synthesize sub-findings into a coherent report."""
        # In production: use an LLM to synthesize
        sections = "\n\n".join(findings)
        return f"# Research Report: {question}\n\n{sections}"

# -- Entry Point ---------------------------------------------------------------

async def main():
    orchestrator = ResearchOrchestrator(
        research_agent_url="https://research-agent.example.com/a2a",
        auth_token="eyJhbGciOiJSUzI1NiJ9..."
    )
    report = await orchestrator.run(
        "Reinforcement learning from human feedback for large language models"
    )
    print(report)

if __name__ == "__main__":
    asyncio.run(main())