
组相对策略优化(Group Relative Policy Optimization, GRPO)[323] 是一种专为语言模型设计的强化学习算法,它消除了对独立评论家(critic)网络的需求。GRPO 由 DeepSeek 在 DeepSeekMath 工作中提出,随后在 DeepSeek-R1 [69] 中被扩展到更大规模,已经迅速成为 LLM 训练中的主流 RL 方法——被大多数开源对齐框架(TRL、OpenRLHF、veRL)作为默认算法采用。
其核心思想看似简单却出人意料地有效:与其训练一个神经网络去预测期望奖励(reward)——即 PPO 中的评论家(critic)——GRPO 通过对同一 prompt 生成多条响应、利用该组的奖励统计量作为 baseline,从经验上估计这一基线。这从显存中去掉了一整个模型,将工程复杂度减半,而且——令人意外的是——往往优于 PPO,因为经验基线比训练不充分的价值函数(value function)更准确。
GRPO 在下列场景中尤其有效:
- 推理任务:具有可验证的奖励(reward)(数学、代码),二值正确性提供干净信号。
- 大模型(70B 及以上):去掉评论家带来的显存节省至关重要。
- 多轮对话(Multi-Turn)与 Agent 场景:跨工具调用(Tool Calling)的价值估计本就难以处理。
本章涵盖 GRPO 的动机、算法、关键变体(Dr. GRPO、DAPO、2-GRPO、GDPO)以及基于 TRL 的实战实现。
动机
PPO 的价值模型(评论家)在语言任务上存在三大问题:
- 显存:价值头(value head)与策略共享主干(70B 模型占 140GB)。若分离则显存翻倍。
- 精度:对部分序列预测期望奖励极其困难。价值函数经常出错 advantage 出错 梯度方向出错。
- 训练:价值头需要大量样本才能收敛。RL 早期它给出嘈杂的预测,破坏策略学习的稳定性。
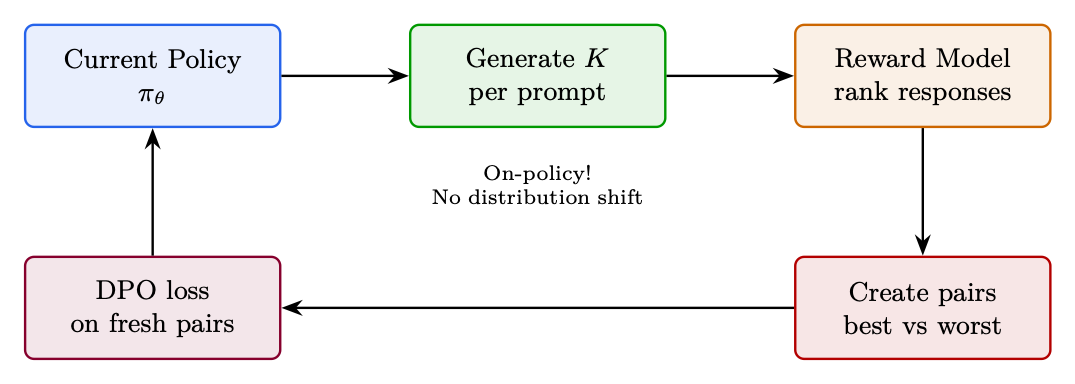
GRPO 的关键洞见[323]:与其学习 ,不如从一组样本中经验地估计它。对同一 prompt 生成 条响应,计算它们的奖励,并用组统计量作为 baseline。
算法
- 对每个 prompt ,采样 条补全(completion):
- 对每条打分:
- 组内归一化:,其中 ,
- 用这些 advantage 应用 PPO 风格的 clipped 更新
TRL 实现
下面给出一个使用 HuggingFace TRL 的最小可运行示例。
from trl import GRPOConfig, GRPOTrainer
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-7B-Instruct",
    torch_dtype=torch.bfloat16, attn_implementation="flash_attention_2")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B-Instruct")

grpo_config = GRPOConfig(
    output_dir="./grpo_output",
    num_generations=8,           # G = group size
    temperature=1.0,             # High temp for diversity within group
    max_completion_length=2048,  # Max response length
    beta=0.04,                   # KL penalty coefficient
    learning_rate=1e-6,
    per_device_train_batch_size=2,  # Prompts per device (x8 gens = 16 responses)
    gradient_accumulation_steps=8,
    num_train_epochs=2,
    bf16=True,
    gradient_checkpointing=True,
    max_grad_norm=0.5,
    logging_steps=10,
    # vLLM generation for speed (critical for GRPO due to 8x generation)
    use_vllm=True,
    vllm_gpu_memory_utilization=0.7,
)

# Reward function: binary correctness for math
def reward_fn(completions, prompts, **kwargs):
    """Return list of floats: 1.0 if correct, 0.0 if wrong."""
    rewards = []
    for completion, prompt in zip(completions, prompts):
        answer = extract_answer(completion)
        expected = get_ground_truth(prompt)
        rewards.append(1.0 if answer == expected else 0.0)
    return rewards

# Can combine multiple reward functions!
def format_reward_fn(completions, **kwargs):
    """Bonus for using proper LaTeX formatting."""
    return [0.5 if "\\boxed{" in c else 0.0 for c in completions]

trainer = GRPOTrainer(
    model=model,
    args=grpo_config,
    reward_funcs=[reward_fn, format_reward_fn],  # Multi-objective!
    train_dataset=math_dataset,
    tokenizer=tokenizer,
)
trainer.train()
组大小分析
信号质量计算开销何时使用2非常嘈杂(如同抛硬币)低不建议使用——过于嘈杂,难以稳定学习4中等中等快速实验、简单任务(通过率 50%)8良好(标准)高默认选择。对大多数任务而言平衡性良好16优秀很高困难任务(通过率 20%),需要多次尝试才能得到正样本32近乎完美极高仅当你拥有海量算力且任务极难时才使用
GRPO 变体与扩展
GRPO 组中的多样性
| 方法 | 它如何促进多样性 |
|---|---|
| 熵奖励 | 在奖励中加入 。直接惩罚低熵(确定性)的策略。 |
| KL 惩罚 | 防止坍塌到单一模式。 |
| 拒绝采样 | 生成大量候选,按奖励保留前 个。自然会筛选出多样且高质量的响应。 |
| Best-of-N | 在推理时:生成 条响应,为全部打分,返回最优者。多样性来自采样。 |
| 使用多样化配对的直接偏好优化(DPO) | 在 chosen/rejected 于方法上有别(而非仅在质量上有别)的配对上训练。 |
| 多奖励 | 使用多个奖励模型(安全性、有用性、代码质量)。防止坍塌到单一维度。 |
表 7.1:RL 训练中促进多样性的方法。
后训练对齐(RLHF、DPO)常常因典型性偏差而降低输出多样性:人类标注者系统性地偏好熟悉、「典型」的文本,而非新颖的替代方案。这种模式坍塌是数据层面的现象,并不纯粹是算法问题。
言语化采样(Verbalized Sampling, VS)[422] 是一种无需训练的 prompting 策略,它要求模型在单次生成中显式说出一个概率分布,从而绕开这种坍塌。
# Verbalized Sampling: prompt model to output distribution
def verbalized_sample(model, tokenizer, task, n=5):
    prompt = (
        f"{task}\n\n"
        f"Generate {n} different responses and assign a probability "
        f"to each (probabilities should sum to 1.0). "
        f"Format: [response] (probability: X.XX)"
    )
    output = model.generate(
        tokenizer(prompt, return_tensors="pt").input_ids,
        max_new_tokens=1024,
        temperature=0.7,
        do_sample=True,
    )
    # Parse responses and probabilities from output
    responses, probs = parse_verbalized_distribution(
        tokenizer.decode(output[0])
    )
    # Sample from the verbalized distribution
    import random
    chosen = random.choices(responses, weights=probs, k=1)[0]
    return chosen
在深入各项扩展之前,先简要回顾前文建立的基础 GRPO 算法。其核心机制——采样一组补全、对其奖励做归一化、再施加 clipped 的策略梯度——十分简洁而优雅。然而,实践者很快发现了若干具体的失效模式:预训练偏差稀释梯度(Dr. GRPO)、对称裁剪限制探索(DAPO)、组规模过大造成浪费(2-GRPO),以及多目标场景下的奖励尺度失衡(GDPO)。以下各节将逐一讨论这些问题。
DAPO ——Dynamic Adaptive Policy Optimization
标准 PPO/GRPO 在 处对重要性比值(importance ratio)做对称裁剪。DAPO 将其替换为非对称的区间:
其中 (典型取值:、)。当 advantage 为正时,策略被允许更进一步朝好的 token 移动;当 advantage 为负时,则适用通常的保守裁剪,以避免过度抑制。
基础 GRPO 将损失除以序列数量。DAPO 则除以所有序列的token 总数:
这样可以防止长补全仅仅因为包含更多 token 就在梯度信号中占据主导。
当一条补全被截断(在最大长度预算内没有出现 EOS token)时,它提供的是误导性信号:模型会因为那些生成正确、却恰好位于截断边界之前的 token 而受到惩罚。DAPO 会将这些补全整体屏蔽掉:
与硬性屏蔽不同,一种更温和的变体施加长度惩罚,它随着补全接近最大长度 而平滑增大:
其中 是「安全」长度阈值。
DAPO 会重新采样那些整组补全都获得相同奖励(全部正确或全部错误)的 prompt,因为这类组在归一化之后贡献的梯度为零。这样可以在整个训练过程中保持有效 batch size 稳定。
GSPO ——Group Sequence Policy Optimization
GSPO [51] 将序列级重要性权重定义为逐 token 比值的几何平均,它等于完整序列概率比的 次方根:
这是经过长度归一化的序列概率比。GSPO 的 loss 对每条序列只裁剪这一个标量:
Dr. GRPO ——Debiased Reward GRPO
Dr. GRPO 修改逐 token 的梯度权重,以考虑该 token 对奖励信号的边际贡献。模型已经赋予高概率的 token(无论奖励如何)会被降权:
其中 是参考(预训练)模型。这是一种token 效率:梯度集中在策略真正需要改变的 token 上。
2-GRPO ——最简的两次 Rollout GRPO
关键洞见在于:GRPO 的有效性并非主要来自精确的 advantage 估计(后者需要很大的 )。相反,它来自一个隐式的对比目标,其结构与 DPO 相似:
其中 是奖励更高的补全, 是奖励更低的补全。当 时,这种对比结构是显式的。当 时,同样的信号仍然存在,但被冗余的配对稀释了。
SAPO ——Soft Adaptive Policy Optimization
SAPO 用一个平滑的代理目标取代 目标:
其中 是 sigmoid 函数, 是非对称的 temperature 参数。temperature 越高,门控越柔和(探索更多);temperature 越低,则越接近硬裁剪。
TIS 与 MIS ——Truncated 与 Masked Importance Sampling
TIS 通过将梯度乘以一个截断后的修正因子来修正偏差:
其中 是训练前向传播得到的概率, 是 vLLM 报告的概率。在 处的截断可防止极端修正破坏训练稳定性。
MIS 采取更激进的做法:对任何修正比超过阈值 的序列,将其梯度置零:
这种做法更保守,但避免了使用较大(即使是截断后的)修正权重的风险。
TIS 与 MIS 既可以应用在 token 级,也可以应用在序列级:
- 序列级:把比值计算为所有 token 上的几何平均(如 GSPO 那样)。理论上正确,但方差更高。
- token 级:为每个 token 分别计算比值。有偏(逐 token 修正的乘积并不等于序列修正),但方差更低。
VESPO ——Variational Sequence-Level Soft Policy Optimization
VESPO 从变分目标出发,为每条轨迹 推导出加权函数 。最终的梯度权重形如:
其中 是序列级重要性权重, 控制加权的锐度, 控制对陈旧(低权重)轨迹的指数衰减。该核:
- 在各处都平滑(裁剪边界处没有不连续的梯度)。
- 通过指数项自然地降低陈旧轨迹()的权重。
- 是非对称的:高权重轨迹()与低权重轨迹的处理方式不同。
DPPO ——Direct Policy Divergence Policy Optimization
DPPO 直接用新旧策略分布之间的全变差(Total Variation, TV)或 KL 散度来计算信赖域约束:
其中 是所选用的散度度量。实践中,DPPO 用 token 级的二值掩码或 top- 掩码来近似它:
- binary_tv:屏蔽满足 的 token。
- binary_kl:屏蔽满足 的 token。
- topk_tv:仅保留按 TV 贡献排序的前 个 token。
- topk_kl:仅保留按 KL 贡献排序的前 个 token。
ScaleRL 和 CISPO
标准 GRPO 在单个 prompt 的 条补全构成的组内对奖励做归一化。CISPO 则在整个 batch范围内对奖励做归一化:
其中 和 在当前训练 batch 的所有奖励(reward)上计算。这提供了更稳定的 baseline,并防止任何单一 prompt 主导 gradient。
CISPO 结合了 batch 级缩放、DAPO 的 token 级 loss 聚合以及非对称 clipping:
其中 是过长过滤 mask。
GDPO ——Group Reward-Decoupled Policy Optimization
其核心机制是在聚合前独立归一化每项奖励:
其中 是补全(completion) 的第 项奖励, 和 是组内奖励 的均值与标准差, 是用户指定的权重。
GOPO ——Group Ordinal Policy Optimization
GOPO [54] 始于一个简单观察:奖励模型是用成对比较(“A 是否优于 B?”)训练的,因此只有其输出的排序是可信的——原始数值分数本身并没有内在含义。然而 GRPO 却把这些原始幅度直接喂入优势计算。对于奖励不可验证的任务——摘要、开放式对话、指令遵循——这种不匹配会引入噪声:在输出空间的某个区域,0.6 个奖励分的差距可能反映真实的质量差异,而在另一个区域却毫无意义。
关键洞见:完全丢弃奖励的幅度信息。只使用组内奖励的序数排名。
算法:给定一组 个响应 ,其奖励为 :
- 按奖励对响应排名:赋予排名 (1 = 最差, = 最好)。
- 将原始优势替换为基于排名的分数:(7.2)其中 是单调变换(例如线性映射到 ,或分位数归一化)。
- 使用基于排名的优势,应用 PPO 风格的 clipped 目标函数。
与 GRPO 的对比:
方面GRPOGOPO优势信号(使用幅度)(仅使用序数排名)对奖励量级的敏感度高——标定不当的 RM 分数会扭曲优势无——对单调奖励变换保持不变最适合的场景可验证的奖励(二值、标定良好)不可验证的奖励(基于 RM、量级含噪)
经验收益(在不可验证任务上相对 GRPO):
- 奖励曲线(训练与 held-out)在整个优化过程中都高于 GRPO
- 由独立 LLM 评估器判定的胜率在大多数训练 checkpoint 上都有提升
- 收敛明显更快——用更少的 gradient step 达到 GRPO 的最终质量
- 当奖励模型噪声更大或标定更差时,这一优势会更加明显